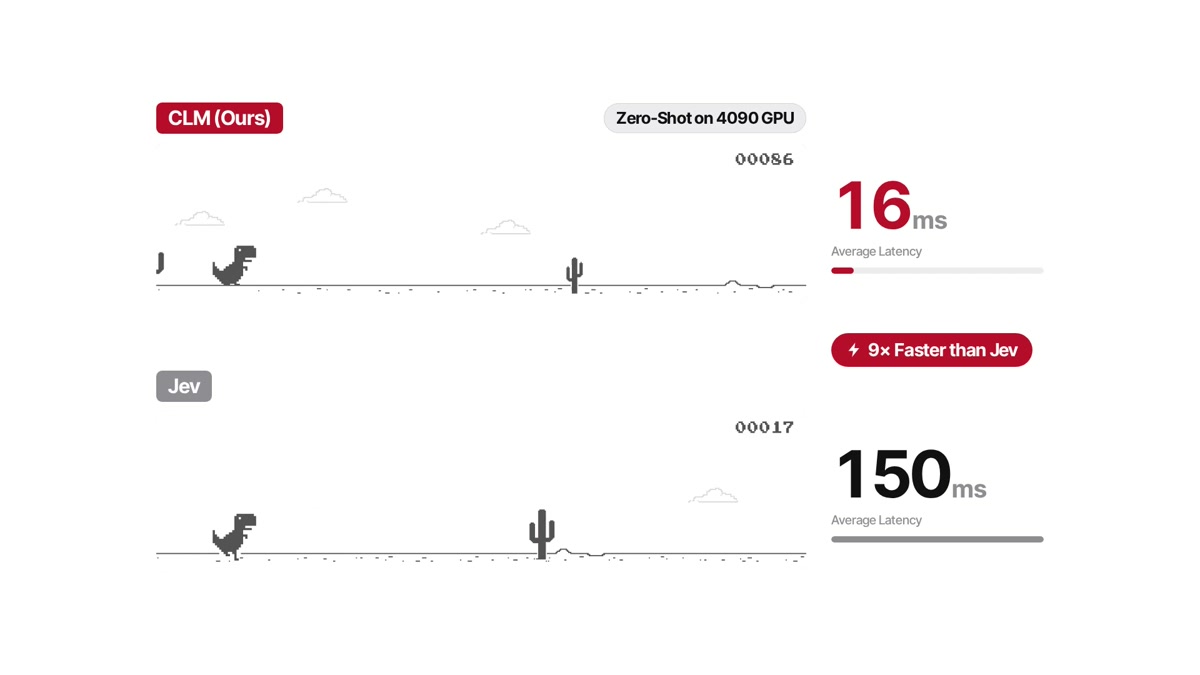
Stanford·NVIDIA 연구진이 참여한 Contrastive-LM 팀이 2026년 9월 24일(한국 시간) 의사결정 모델 CLM-8B의 코드와 가중치를 공개했습니다. 현재 상황과 후보 행동을 각각 벡터로 바꿔 비교하는 System One 모델로, 컴퓨터 사용·게임·도구 호출에서 Jev와 비슷한 성능을 내면서 최대 9배 낮은 지연 시간을 보였다고 보고했습니다. 코드와 공개된 CLM 전용 헤드 가중치는 Apache-2.0 라이선스입니다.
발표 영상은 약 1분 19초입니다. 저장소의 CLM 코드, Hugging Face 모델 카드, 프로젝트 소개에서 구성과 실행 방법을 확인할 수 있습니다.
Jev와 CLM, 에이전트의 선택을 빠르게
Jev는 TypeSafe의 System One 결정 모델입니다. 에이전트가 정한 후보 중 하나를 고르는 Choice, 참·거짓을 판별하는 Noul, 기준표에 따라 점수를 매기는 Score처럼 구조화된 판단을 처리합니다.
CLM-8B도 같은 형태의 API를 제공하지만 선택지를 비교하는 방식이 다릅니다. 현재 상태와 후보 행동을 각각 인코딩해 벡터로 만들고, 두 벡터의 유사도가 가장 높은 행동을 선택합니다. 예를 들어 화면 상태를 읽은 다음 “설정 버튼 누르기”와 “뒤로 가기”를 후보로 받으면, 화면 맥락과 각 행동 설명을 비교해 더 어울리는 쪽을 고릅니다.
후보 행동의 벡터는 캐시에 저장해 다음 상태에서도 재사용할 수 있습니다. 화면 상태가 바뀌면 상태 벡터를 새로 만들고, 이미 계산한 행동 벡터와 점수를 계산합니다. 메뉴 항목이나 도구 목록처럼 후보가 반복되는 작업에서 이 구조가 속도 이점을 만듭니다.
컴퓨터 사용부터 코딩 검증까지
공개된 zero-shot 평가에서 CLM-8B는 컴퓨터 사용, 게임, 도구 호출 과제의 Jev와 비슷한 성능을 보이며 최대 9배 낮은 지연 시간을 기록했습니다. 후보 행동이 약 1,000개인 조건에서는 발표 평가에서 Jev보다 최대 13배 빠른 결과를 제시했습니다.
| 평가 | 결과 | 조건 |
|---|---|---|
| 컴퓨터 사용·게임·도구 호출 | Jev와 비슷한 성능, 최대 9배 낮은 지연 | 공개 zero-shot 비교 |
| 대규모 행동 후보 | 최대 13배 빠름 | 후보 약 1,000개 조건 |
| DeepSWE | 81.6% (31/38) | 검증기 용도로 미세 조정한 헤드, held-out 과제 38개 |
| Terminal-Bench 2.1 | 87.6% | 검증기 용도로 미세 조정한 헤드, held-out 과제 30개 |
DeepSWE와 Terminal-Bench 수치는 CLM-8B를 여러 후보 해법 중 최선의 결과를 고르는 검증기로 사용하고, 해당 작업에 맞춰 헤드를 가볍게 미세 조정한 결과입니다. 기본 zero-shot 평가와 구분해 읽을 수 있습니다.

세 단계로 상태와 행동을 학습
학습은 질문과 답변을 상태와 행동으로 삼는 대규모 사전 학습에서 출발합니다. 이후 정답과 의미가 비슷한 오답을 구별하는 단계를 거치고, 마지막에는 에이전트가 실제로 작업한 기록에서 상황과 선택의 관계를 배웁니다.
- 약 6,000만 개 Nemotron 질문·답변 쌍으로 폭넓은 상태·행동 표현을 사전 학습합니다.
- 약 3,000만 개 합성 하드 네거티브로 비슷하지만 잘못된 행동 후보를 구별하도록 중간 학습합니다.
- 약 100만 개 에이전트 궤적과 터미널 기록으로 실제 작업 맥락의 결정을 후속 학습합니다.

CLM-8B 설치와 서버 실행
빠른 시작 환경은 Python 3.10 이상, Linux, NVIDIA GPU입니다. CLM API 서버와 Qwen3-8B 임베딩 서버를 실행하며, CLM 전용 헤드 체크포인트 75MB는 첫 실행 때 Hugging Face에서 내려받습니다. Qwen3-8B 인코더는 별도로 구동합니다.
git clone https://github.com/Contrastive-LM/CLM.git && cd CLM
pip install -r requirements.txt

# Qwen3-8B 임베딩 서버
vllm serve Qwen/Qwen3-8B --served-model-name qwen3-8b --runner pooling \
  --enable-prefix-caching --max-model-len 2048 \
  --gpu-memory-utilization 0.35 --port 8090

# CLM API 서버
clm-serve --port 8700 --emb-url http://127.0.0.1:8090/v1/embeddings
Python 클라이언트는 Choice·Noul·Score 판단을 한 번의 system_one 호출로 묶을 수 있습니다. 아래 예제는 고객 문의의 긴급도, 담당 부서, 감정 점수를 함께 분류합니다.
from clm import CLMClient, Choice, Noul, Score

client = CLMClient()  # 기본 주소 http://127.0.0.1:8700
result = client.system_one(
    state="고객이 청구 금액이 두 번 결제됐고 전화 연결이 되지 않는다고 문의했습니다.",
    questions={
        "urgency": Noul(instructions="긴급한 문의인가요?"),
        "department": Choice(
            instructions="어느 팀이 담당해야 하나요?",
            criteria={"billing": "결제, 청구서, 환불", "technical": "오류와 서비스 장애"},
        ),
        "frustration": Score(
            instructions="고객의 불만 수준은 어느 정도인가요?",
            criteria=["차분함", "불만", "매우 화남"],
        ),
    },
)
print(result.answers["department"].choice)
텍스트 후보를 직접 순위화할 때는 저장소의 Engine.rank()를 쓸 수 있습니다. API 서버는 기본적으로 웹 플레이그라운드도 제공하며, 서버 주소와 API 키는 CLM_BASE_URL, CLM_API_KEY 환경 변수로 설정합니다.
Apache-2.0 공개와 CLM-35B
CLM 코드와 공개된 75MB 헤드 가중치의 라이선스는 Apache-2.0입니다. CLM-8B 구성은 Qwen3-8B 인코더와 CLM 결정 헤드를 결합합니다. 연구진은 이미지와 영상 등 멀티모달 입력을 다루는 CLM-35B도 학습하고 있다고 예고했습니다.