코딩 에이전트 둘이 같은 Supabase 로컬 DB를 쓰면 어떤 일이 생길까요? 한쪽에서 만든 테스트 데이터가 다른 쪽 작업에 섞일 수 있습니다. Supabase는 이 문제를 줄이기 위해 Docker 없는 로컬 실행과 여러 격리 스택을 실험하고 있어요. 다만 같은 저장소와 브랜치에서 실행한 에이전트까지 자동으로 분리해 주는 건 아닙니다.
장시간 실행할 에이전트와 서비스를 위한 Supabase Compute도 공개됐지만, 현재는 비공개 알파 단계입니다. Postgres 저장 엔진 OrioleDB는 공개 베타에 들어갔죠. 발표에서 언급한 최대 1.8배 처리량은 특정 서버와 TPC-C 파생 테스트에서 나온 결과입니다. 내 작업에서도 같은 차이가 난다고 단정할 수는 없어요.
Docker 없이 로컬에서 실행하면 무엇이 달라질까요?
새 런타임은 Supabase 서비스를 컨테이너가 아니라 컴퓨터의 네이티브 프로세스로 실행합니다. Docker를 설치하거나 관리하지 않고 로컬 개발을 시작하고 싶은 팀이라면 반가운 변화겠죠. 아직 알파 기능이고 기본 설정은 꺼져 있습니다. 사용하려면 Supabase CLI 2.119.0 이상이 필요하며, 운영체제와 아키텍처가 지원되는지도 확인해야 합니다. 알파인 만큼 설정과 동작은 달라질 수 있어요. 자세한 조건은 Supabase 발표와 로컬 프로젝트 가이드에서 확인할 수 있습니다.
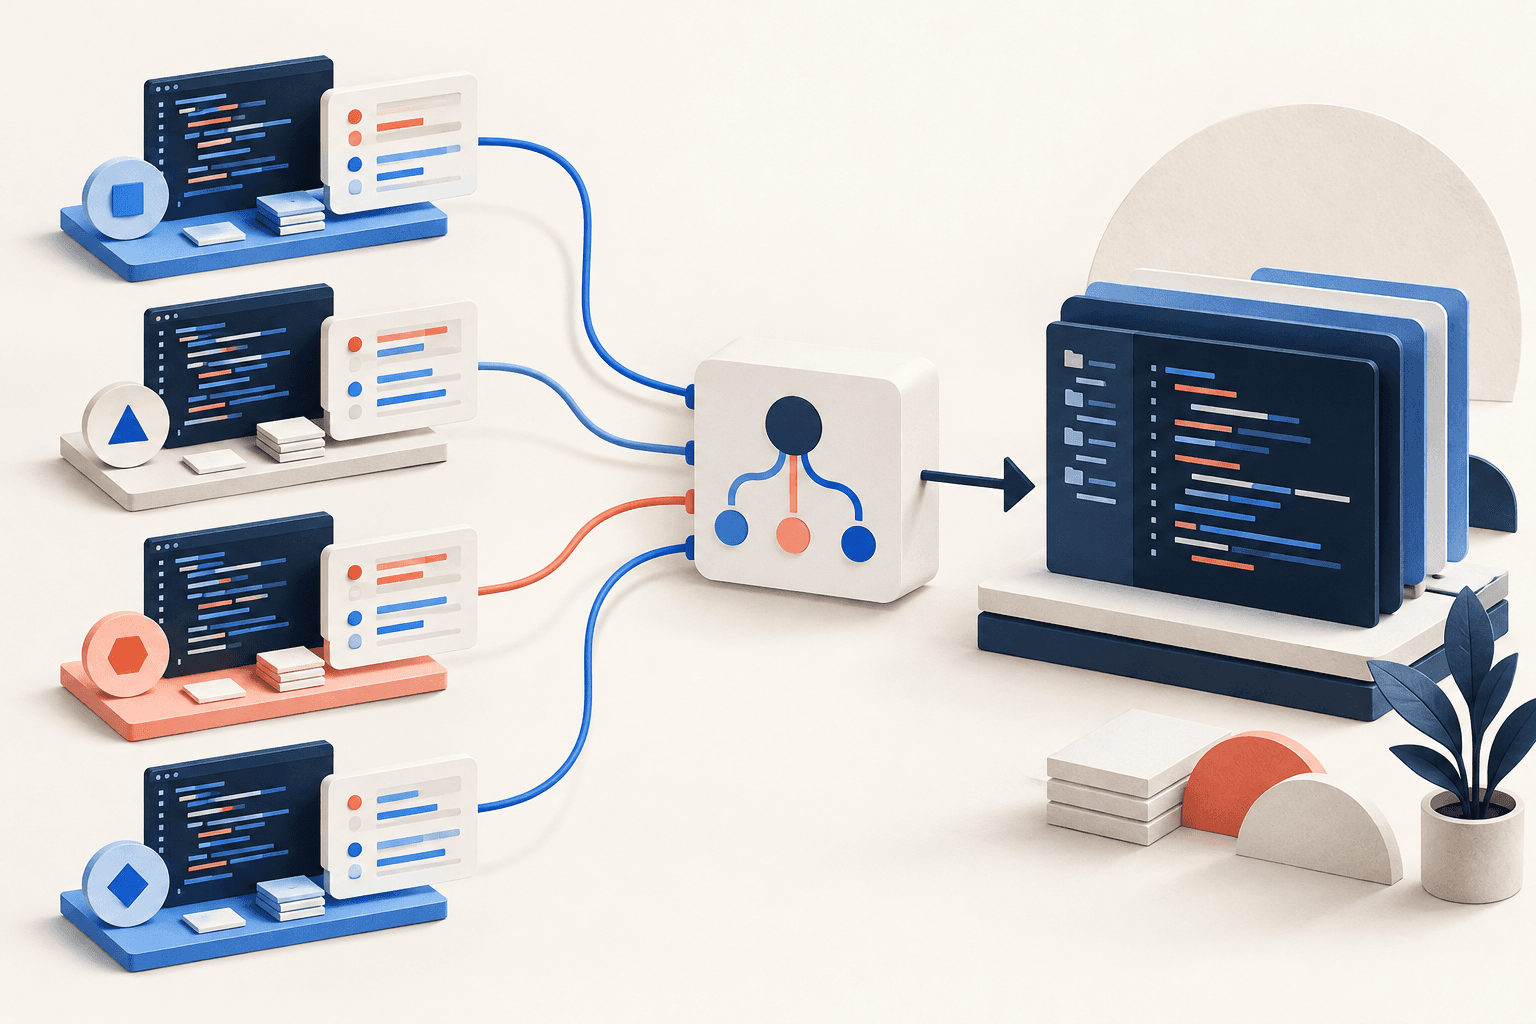
여러 인스턴스는 프로젝트 경로와 Git 브랜치, 필요하면 지정하는 --stack 이름을 기준으로 나뉩니다. 각 스택은 포트와 데이터 디렉터리를 따로 사용하죠. 에이전트마다 worktree를 만들거나 서로 다른 stack 이름을 지정하면 독립된 로컬 환경을 구성할 수 있습니다.
여기서 놓치기 쉬운 점이 있습니다. 같은 checkout과 브랜치에서 병렬 실행하면 자동 격리가 되지 않고, Supabase 설정 디렉터리도 공유할 수 있어요. 여러 인스턴스를 동시에 운영해야 한다면 Docker나 Podman 방식이 권장됩니다. 네이티브 런타임을 쓸 때는 작업 공간부터 나누고 지원 조건을 살펴보세요. 에이전트 중심 개발 흐름은 GitHub Spec Kit의 단계별 개발 방식을, 여러 에이전트를 한 환경에서 다루는 사례는 Spotify Xirp 사례에서 이어서 볼 수 있습니다.
에이전트를 클라우드에서 계속 돌리는 Compute
로컬 개발을 마친 뒤 에이전트나 백그라운드 서비스를 데이터베이스 가까이에서 계속 실행하고 싶을 수 있죠. Supabase Compute는 그 용도를 겨냥합니다. Linux에서 원하는 언어로 HTTP 서비스와 백그라운드 작업, 격리된 실행 환경을 배포하고 CPU와 메모리를 선택하는 방식입니다. 대시보드에서 런타임 상태와 호출, 로그를 확인하고 Compute용 에이전트 스킬로 모니터링과 디버깅을 도울 수 있다고 소개했어요.
다만 누구나 바로 쓸 수 있는 정식 서비스는 아닙니다. 지금은 대기 목록을 받는 비공개 알파 단계예요. 배포와 관리는 CLI 및 Management API를 통해 설명하고 있습니다. 대시보드와 스킬의 관찰·디버깅 기능을 MCP 관리 기능과 혼동하지 않도록 구분해야 합니다. 현재 접근 단계는 Supabase Compute 안내에서 확인해 보세요.
앱 자체에 MCP 서버를 연결하는 기능은 별도 흐름입니다. 인증된 Edge Function으로 구현하며, 로그인한 사용자의 권한과 RLS에 맞춰 데이터에 접근하게 하죠. 프로젝트 관리용 MCP나 Compute 모니터링과는 다른 기능입니다. 앱용 MCP 서버 사례가 궁금하다면 ChatGPT Sites의 MCP 확장도 참고할 수 있습니다.
OrioleDB 베타, 기존 프로젝트에도 켤 수 있을까요?
OrioleDB는 Postgres의 기본 저장 방식인 Heap을 대체하는 저장 엔진입니다. 새 Supabase 프로젝트를 만들 때 선택해야 하고, 기존 프로젝트에 나중에 추가하거나 제거할 수는 없습니다. 공개 베타에 들어갔지만 프로덕션 사용은 권장되지 않으며 SLA도 제공되지 않아요.
복구와 호환성 조건도 먼저 살펴봐야 합니다. PITR(특정 시점 복구)을 지원하지 않고, 백업을 새 프로젝트로 복원하는 기능도 제공되지 않습니다. B-tree 외 인덱스는 제한적이고 일부 확장은 제공 이미지에 빠져 있어요. self-hosted Supabase 전체 스택에도 아직 포함되지 않았습니다. 도입 전 지원 범위를 공개 베타 변경 로그와 OrioleDB 문서에서 확인하세요.
‘최대 1.8배’는 어떤 테스트에서 나온 수치일까요?
Supabase는 OrioleDB와 기본 Postgres Heap의 처리량을 비교했습니다. 테스트에는 8XL 컴퓨트 인스턴스(32 vCPU, 메모리 128 GiB)와 메모리보다 큰 데이터셋을 사용했고, PostgreSQL 17에 TLS로 직접 연결했습니다. 플랫폼 기본 설정에서 대기 시간(think time)을 두지 않은 TPC-C 파생 워크로드를 실행해 분당 트랜잭션(tpmC)을 비교한 결과, OrioleDB가 약 1.8배를 기록했어요.
이 수치를 모든 환경에 그대로 적용하기는 어렵습니다. 테스트는 TPC-C에서 파생됐지만 정식 규격을 모두 따르지 않아 공식 TPC-C 점수와 직접 비교할 수 없어요. 서버 사양이나 데이터, 쿼리가 달라지면 결과도 달라집니다. 실제 도입을 검토한다면 내 워크로드로 따로 측정하는 편이 정확하겠죠. 세부 조건과 차트는 Supabase OrioleDB 문서에서 볼 수 있습니다.
내 작업에 맞는 기능인지 먼저 따져보기
Docker 없는 네이티브 실행과 다중 스택은 아직 알파·실험 기능입니다. 에이전트별로 경로와 브랜치, stack 이름을 명시적으로 나눠야 데이터가 섞이지 않아요. Compute는 비공개 알파라 대기 목록 단계이고, OrioleDB는 공개 베타지만 운영 보장이나 기존 프로젝트 전환을 기대하기 어렵습니다.
먼저 로컬 에이전트의 작업 공간을 분리해 보세요. OrioleDB는 복구 방식과 확장 호환성을 확인한 뒤 테스트 프로젝트에서 성능을 측정하는 게 좋습니다. 발표에 나온 숫자보다 내 서비스의 데이터와 쿼리가 더 직접적인 판단 기준이니까요.