3줄 요약
- TypeLLM은 모델 가중치를 바꾸지 않고 SGLang 위에서 LLM 답을 문자열·정수·숫자·참거짓·선택지 타입 그대로 돌려주는 오픈소스입니다(Apache 2.0).
- 선택지는 정해진 후보 안에서만 고르고 결과가 파이썬 딕셔너리로 바로 나와 JSON 파싱 에러가 없습니다.
- Thinking은 그대로 켤 수 있고, 영수증 같은 데이터 추출과 에이전트 파이프라인에 바로 붙일 수 있습니다.
LLM을 서비스에 붙이면 JSON이 깨지거나, 정해 둔 목록에 없는 값이 답으로 나올 때가 있습니다. TypeLLM은 오픈 모델을 SGLang으로 직접 서빙하는 환경에서 모델 가중치를 바꾸지 않고 각 답을 문자열·정수·숫자·참거짓·선택지 같은 타입에 맞춰 돌려주는 오픈소스입니다. 2026년 9월 17일 21:41(한국 시간)에 공개됐고, 9월 27일 기준 GitHub 스타 767개, Apache 2.0 라이선스입니다. 공식 @TypeLLM은 9월 27일 01:24(한국 시간) 공정한 주사위 실험과 함께 TypeLLM을 소개했습니다.
출처: X @TypeLLM
1. 어떻게 타입을 지키나
선택지를 받을 때 TypeLLM은 각 후보에 A, B, C처럼 한 토큰짜리 라벨을 붙입니다. 모델이 그 라벨 중 어떤 것을 선택하는지 점수만 읽으므로 목록 밖의 선택지가 답으로 나올 수 없습니다. 선택지는 최대 24개까지 지원합니다. 선택형 답은 토큰 하나로 끝나 출력 토큰도 거의 들지 않습니다.
참·거짓은 두 후보 중 하나로 처리합니다. 정수와 실수는 유효한 숫자 토큰만 허용하며 기본 길이는 최대 32자리입니다. 문자열은 JSON 문자열로 생성하고 maxLength를 지정해 길이를 제한할 수 있습니다. 결과는 Python 딕셔너리로 바로 받습니다. 타입과 선택지는 지켜 주지만, 자유 문장의 내용이 맞는지는 모델의 능력에 달려 있습니다.
2. Thinking을 켜도 된다
TypeLLM은 모델이 평소처럼 <think> 블록 안에서 추론하도록 두고, 최종 답을 내는 시점에 타입 제한을 적용합니다. thinking=True로 사고 과정을 켜고 thinking_budget=2048처럼 필드별 토큰 상한을 둘 수 있습니다.
3. 설치하고 첫 실행
Python 3.10 이상과 GPU 모델을 직접 서빙하는 SGLang 서버가 필요합니다. TypeLLM은 GPT나 Claude 같은 호스팅 API 모델에 SDK만 연결하는 방식이 아니라, 호환되는 오픈 모델 서버를 준비해 사용합니다. 다음은 공식 Qwen3.8-27B 가이드의 SGLang 실행 예시입니다. TP=4로 모델을 나누어 서빙합니다.
sglang serve --model-path Qwen/Qwen3.8-27B --port 30000 --tp-size 4 \
  --context-length 262144 --reasoning-parser qwen3 --tool-call-parser qwen3_coder
README 안내대로 prefix caching을 켠 상태로 서버를 띄운 뒤 SDK를 설치합니다.
pip install -U typellm영수증에서 상호·합계·비용 분류·환급 여부·확신도를 추출하는 예시입니다.
from typellm import TypeLLMClient

client = TypeLLMClient("http://127.0.0.1:30000", model="Qwen/Qwen3.8-27B")
result = client.generate(
    context="""Receipt from Hilton London
Total: £324.50
Employee travelled to London for a client meeting.""",
    questions={
        "merchant": {"type": "string", "instructions": "Return only the merchant name."},
        "total": {"type": "number", "instructions": "Extract the total amount in GBP."},
        "expense_type": {"type": "string", "enum": ["meal", "travel", "equipment"],
                         "instructions": "What type of expense is this?"},
        "reimbursable": {"type": "boolean", "instructions": "Should this expense be reimbursed?"},
        "confidence": {"type": "number", "enum": [0.0, 0.25, 0.5, 0.75, 1.0], "instructions": "How confident are you?"},
    },
)
print(result)
실행 결과는 JSON 문자열이 아니라 바로 쓸 수 있는 Python 딕셔너리입니다.
{'merchant': 'Hilton London', 'total': 324.5, 'expense_type': 'travel', 'reimbursable': True, 'confidence': 0.75}공식 지원 모델은 다음과 같습니다.
| 모델 | Thinking |
|---|---|
| Qwen/Qwen3.8-27B | 켜기·끄기 |
| Qwen/Qwen3.5-0.8B / 4B / 9B | 켜기·끄기 |
| openbmb/MiniCPM5-1B | 켜기·끄기 |
| inclusionAI/Ling-mini-2.0 | 끄기 |
| inclusionAI/Ring-mini-2.0 | 항상 켜기 |
Qwen3.8-27B는 이미지 입력도 지원합니다. Claude Code나 Cursor에서는 아래 지시문으로 프로젝트 설정을 시작할 수 있습니다.
Read https://typellm.ai/SKILL.md and follow it to set up TypeLLM in this project.TypeLLM Quick Start · Qwen3.8 SGLang 가이드 · 공식 SKILL.md
4. 에이전트 파이프라인에 쓰는 기능
긴 입력의 공통 앞부분은 SGLang prefix KV cache로 재사용하고, 서로 독립적인 질문은 한꺼번에 처리할 수 있습니다. 앞선 답에 따라 다음 질문이 달라지면 depends_on으로 의존 관계를 선언해 순서를 구성합니다. return_probabilities=True를 사용하면 선택지별 확률도 돌려받아 후속 로직에서 신뢰도를 다룰 수 있습니다.
선택지 순서에 따라 모델의 선호가 달라지는 현상은 permutation averaging으로 완화합니다. permutations: "auto"는 균형 잡힌 순서를 선택해 점수를 평균합니다. TypeLLM이 소개한 공정한 주사위 실험에서는 8개 순서 평균으로 KL 오차가 약 79%, 720개 전체 순서 평균으로 약 97% 줄었습니다.
출처: X @TypeLLM
일본의 한 개발자(@yasuhiks)는 9월 26일 22:57(한국 시간) 영수증·증빙에서 문자열·숫자·선택지를 타입대로 뽑아내는 사용법을 소개했습니다.
출처: X @yasuhiks
Type-safe workflow · Fair die 실험
5. JevBench에서 Thinking으로 98.70%
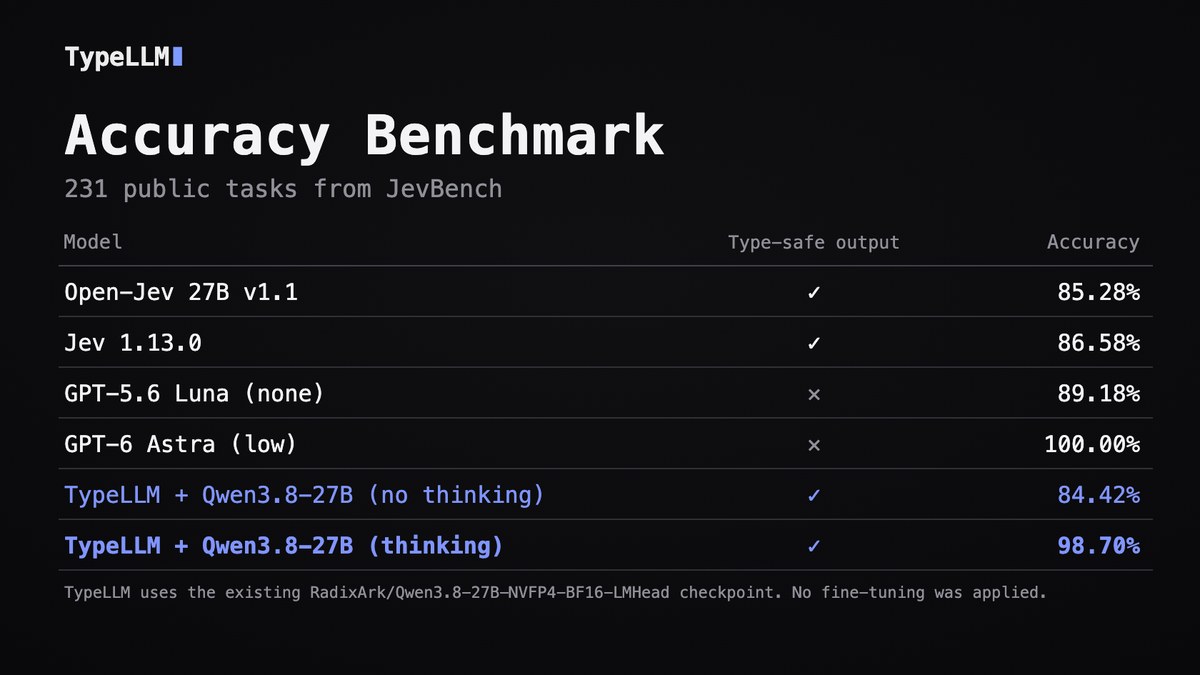
TypeLLM 저장소의 공개 JevBench 231문항 실행에서 Thinking 없이 195개(84.42%), Thinking을 켜면 228개(98.70%)를 맞혔습니다. 요청당 중앙값은 각각 1.3초와 6.7초였습니다. 비교 대상으로 제시된 Open-Jev 27B v1.1은 85.28%, Jev 1.13.0은 86.58%였습니다. TypeLLM 쪽은 Qwen3.8-27B 공개 체크포인트를 추가 학습하지 않고 사용했습니다. 비교 구성과 평가 환경은 저장소의 JevBench 설명에서 볼 수 있습니다.
JevBench는 여러 유형의 의사결정 문제를 모델이 얼마나 정확히 푸는지 보는 벤치마크입니다. TypeLLM은 TypeSafe AI의 Jev에서 영감을 받았다고 설명합니다. Jev는 전용 의사결정 모델이고 TypeLLM은 기존 오픈 모델을 SGLang에서 타입에 맞게 쓰는 별도 오픈소스 구현입니다.
6. 업데이트 흐름과 호스팅 API
- 9월 18일: 정수·숫자 출력 지원
- 9월 19일: Thinking 모드 추가
- 9월 22일:
depends_on의존성 그래프와 prefix 재사용 - 9월 23일: JevBench 결과와 permutation averaging
- 9월 24일: Qwen3.8-27B 이미지 입력
자체 GPU 서버 대신 호스팅 API를 쓰고 싶다면 TypeLLM Early Access에서 신청할 수 있습니다.
SGLang으로 오픈 모델을 서빙하고 있다면 pip install -U typellm 한 줄로 파싱 코드부터 걷어 내 보세요.