분류나 라우팅처럼 답의 범위가 정해진 일을 맡길 때, 매번 큰 언어 모델의 문장 생성을 거쳐야 할까요? Unsloth는 Qwen이나 Gemma 같은 기존 LLM을 LoRA로 미세 조정해, 후보를 직접 고르고 확률을 반환하는 의사결정 모델로 바꾸는 학습 흐름을 공개했습니다.
가이드의 대표 실험은 Qwen3.5-0.8B입니다. 4GB VRAM에서 42분 학습했고, 세 가지 의사결정 벤치마크의 종합 정확도는 20.7%에서 74.3%로 올랐습니다. 다만 2.5GB에서 10분, 77%라는 숫자는 이 모델 실험이 아니라 별도로 추가 학습한 Laya 사례입니다. 두 조건을 섞지 않고, 실제로 따라 해 볼 수 있는 학습 경로까지 살펴보겠습니다.
문장을 만드는 LLM을 선택하는 모델로 바꾸기
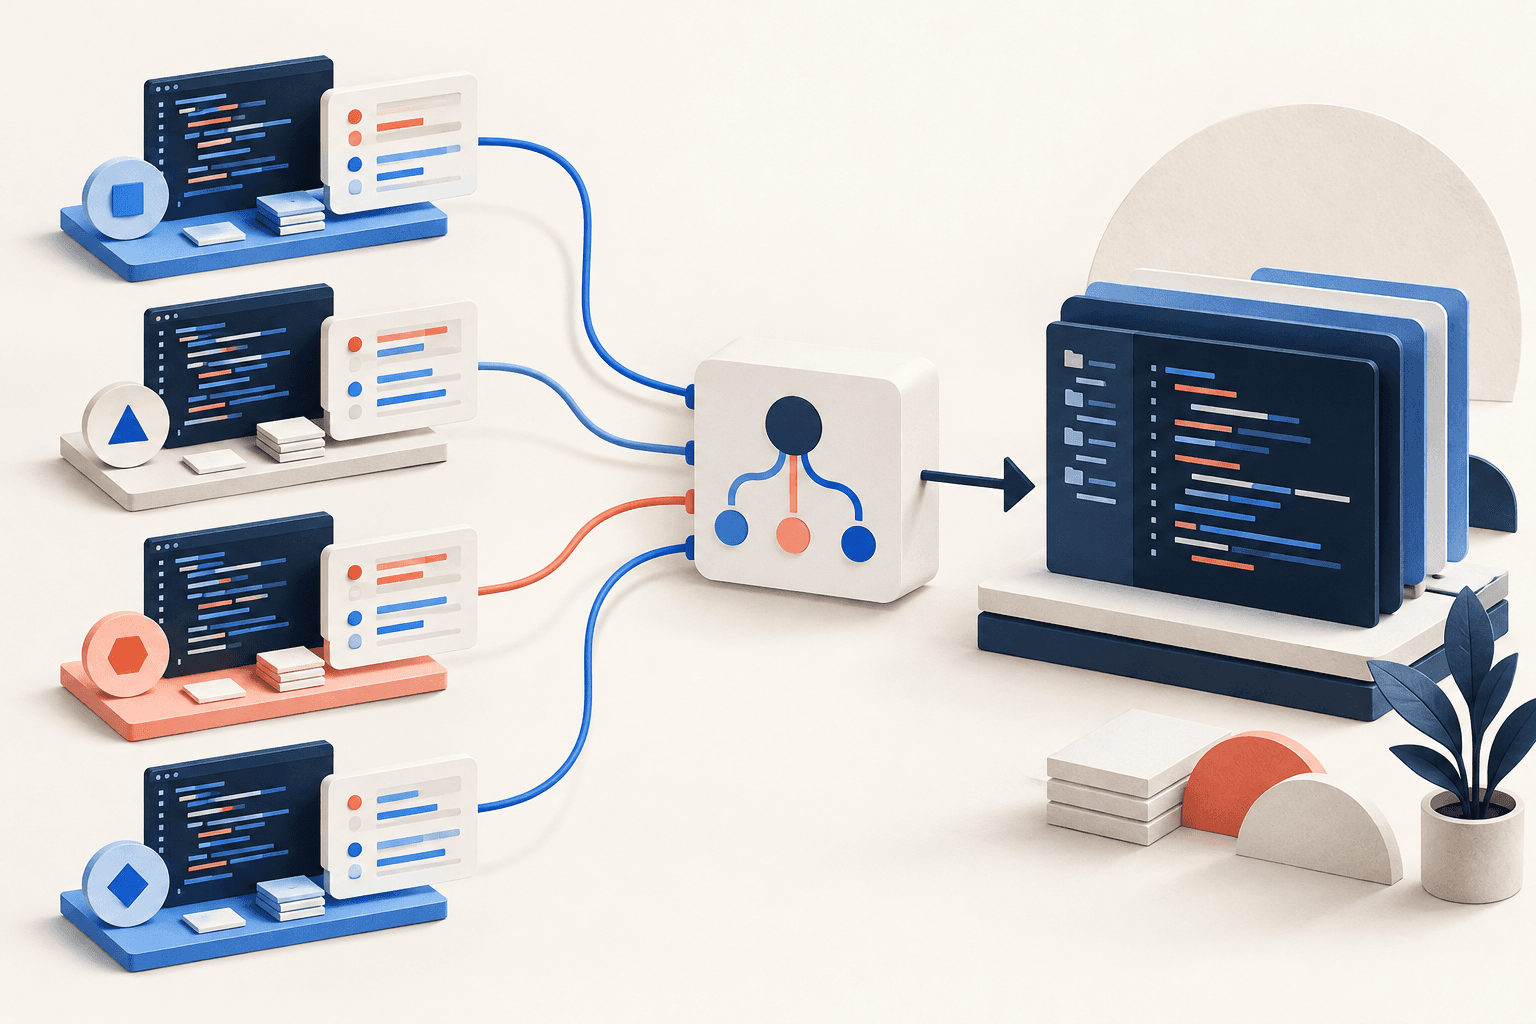
일반적인 LLM은 입력을 받아 다음 토큰을 생성합니다. 의사결정 모델은 상태와 질문, 선택지를 입력받고 각 질문에 맞는 답과 확률을 돌려줍니다. 예를 들어 고객 문의를 읽고 담당 팀을 고르거나, 환불 요청 여부를 참·거짓으로 판정하고, 정해 둔 기준표에 따라 점수를 매기는 식입니다.
Unsloth 가이드는 기반 LLM에 LoRA(rank 64)와 Clef 계열 decision head를 적용하는 접근을 설명합니다. 공개된 학습 비교는 1 epoch로 구성됐고, Qwen3.5-0.8B는 세 벤치마크에서 각각 다음과 같은 변화를 보였습니다.
벤치마크 | 학습 전 | 학습 후 |
|---|---|---|
typed-decisions | 36% | 73% |
BANKING77 | 7% | 74% |
CLINC150 | 19% | 76% |
세 벤치마크 평균 | 20.7% | 74.3% |
평균은 세 benchmark의 정확도를 단순 평균한 값입니다. 별도의 holdout 정확도 표에는 Qwen3.5-0.8B가 78%로 제시되어 있으므로, 74.3% 종합과 78% holdout을 같은 평가값처럼 읽지 않아야 합니다. Unsloth는 테스트셋이 학습 데이터와 중복되지 않도록 decontamination했다고 밝힙니다.
Unsloth Desktop에서 직접 학습하기
GUI를 이용하면 Unsloth Desktop을 설치한 뒤 Train 탭에서 모델을 고르고 Train as → Decision model을 선택하면 됩니다. 설정은 가이드의 기본 권장값을 바탕으로 시작할 수 있습니다.
Unsloth Desktop을 설치합니다. 공식 안내는 macOS, Windows, Linux를 지원합니다. 수동 설치를 원하면 macOS·Linux·WSL에서는
curl -fsSL https://unsloth.ai/install.sh | sh, Windows PowerShell에서는irm https://unsloth.ai/install.ps1 | iex를 사용합니다.Train 탭에서 모델을 선택하고 학습 유형을 Decision model로 지정합니다. 결과 재현 설정은 epochs 2, LoRA rank 16, learning rate 2e-4입니다.
Hugging Face 데이터셋 또는 파일을 선택합니다.
typed-decisions를 쓸 때 Subset은all로 설정하세요.학습을 실행한 뒤 held-out decision 정확도와 confidence calibration 결과를 확인합니다. 준비된 모델은 Use in Decision API로 연결할 수 있습니다.
공식 실험 소개에서는 rank 64로 1 epoch를 사용했지만, 재현용 Desktop 및 Python 절차는 rank 16과 2 epochs를 제시합니다. 서로 다른 실험·워크플로 설정이므로 숫자를 한 설정으로 합치지 않는 편이 정확합니다.
Python으로 데이터와 학습 설정을 직접 제어하기
코드에서는 FastDecisionModel과 DecisionTrainer를 사용합니다. 공식 예시는 Qwen3.5-4B를 불러오지만, 모델 이름을 바꾸면 Llama 3.2 3B나 Gemma 4 E4B도 같은 틀로 적용할 수 있다고 안내합니다.
from unsloth import FastDecisionModel, DecisionTrainer, is_bfloat16_supported
from datasets import load_dataset
from transformers import TrainingArguments

model, tokenizer = FastDecisionModel.from_pretrained(
    model_name="unsloth/Qwen3.5-4B",
    max_seq_length=2048,
    load_in_4bit=True,
)
model = FastDecisionModel.get_peft_model(
    model, r=16, lora_alpha=16, lora_dropout=0,
    use_gradient_checkpointing="unsloth", random_state=3407,
)

dataset = load_dataset("LocalLLaMA/typed-decisions", "all", split="train")
items, report = FastDecisionModel.build_dataset(dataset, tokenizer, model)
print(f"Skipped {report['skipped']} of {report['total']} decisions")
train_items, eval_items = FastDecisionModel.split_holdout(items, seed=3407)

trainer = DecisionTrainer(
    model=model, processing_class=tokenizer,
    train_dataset=train_items, eval_dataset=eval_items,
    args=TrainingArguments(
        per_device_train_batch_size=8,
        gradient_accumulation_steps=4,
        num_train_epochs=2,
        learning_rate=2e-4,
        lr_scheduler_type="cosine",
        warmup_steps=10,
        weight_decay=0.01,
        bf16=is_bfloat16_supported(),
        fp16=not is_bfloat16_supported(),
        eval_strategy="epoch",
        logging_steps=10,
        output_dir="outputs",
        report_to="none",
        seed=3407,
    ),
)
trainer.train()
metrics = FastDecisionModel.calibrate(model, tokenizer, eval_items)
print(metrics)  # holdout accuracy, ECE, loss
학습 데이터는 state, 판정할 질문, 정답으로 구성됩니다. build_dataset이 예시를 모델 입력 형식으로 바꾸고, split_holdout이 평가용 데이터를 분리합니다. 보고서의 skipped 수를 확인해 입력 변환 중 제외된 항목이 얼마나 되는지도 살펴보세요. 메모리가 빠듯하다면 batch size를 절반으로 낮추고 gradient accumulation을 두 배로 높이는 방법을 가이드가 권합니다.
VRAM과 시간은 모델별로 다릅니다
가이드에 적힌 수치는 각 모델과 평가 조건의 예시입니다. 모델 크기만 보고 필요한 GPU 메모리를 단정하지 말고, 자신의 데이터 길이·batch 설정·하드웨어에서 여유를 확인해야 합니다.
모델 | 정확도 | VRAM | 학습 시간 |
|---|---|---|---|
Qwen3.5-0.8B | 78% | 4GB | 42분 |
Qwen3.5-2B | 81% | 8GB | 40분 |
Llama 3.2 3B | 79% | 4.1GB | 30분 |
Gemma 4 E4B | 77% | 14.4GB | 49분 |
Laya 추가 학습 | 77% | 2.5GB | 10분 |
Laya의 2.5GB·10분·77%는 Qwen3.5-0.8B 결과가 아닙니다. 이미 의사결정 모델인 Laya를 추가 학습한 별도 사례입니다. 반면 Qwen3.5-0.8B 행의 78%는 가이드 표의 test accuracy이며, 글 제목의 20.7%→74.3%는 typed-decisions·BANKING77·CLINC150 세 벤치마크 평균을 가리킵니다.
보정과 배포까지 이어가기
의사결정에서는 답뿐 아니라 확률을 얼마나 믿을 수 있는지도 중요합니다. 공식 예시는 holdout 데이터로 모델을 보정하고 정확도, ECE(calibration error), loss를 확인합니다. 보정에 사용한 항목이 학습에 섞이지 않도록 holdout 분리를 유지하세요.
FastDecisionModel.predict(model, tokenizer, state, questions)로 추론할 수 있습니다. choice 유형은 후보 key와 후보별 확률, noul 유형은 true/false, score 유형은 정의한 단계 번호를 반환합니다. 저장은 adapter와 head를 함께 남기는 save_pretrained 또는 전체 16-bit 모델로 병합하는 save_pretrained_merged를 지원합니다.
병합 모델을 Studio에서 불러올 때는 다음처럼 모델 경로를 지정합니다. 첫 GPU 로드에는 수 분이 걸릴 수 있습니다.
UNSLOTH_SYSTEMONE_MODEL=/path/to/qwen-decisions-merged unsloth studio -H 0.0.0.0 -p 8888모델은 state와 질문·선택지를 함께 읽고 옵션에 점수를 매기는 구조입니다. 자연어 답변을 생성하지 않아도 분류·라우팅 같은 정형 의사결정을 다룰 수 있죠. 실제 적용에서는 공개 벤치마크뿐 아니라 운영에서 사용할 질문, rubric, 선택지와 유사한 자체 평가셋을 구성하고, 정확도와 확률 보정을 따로 확인하는 것이 좋습니다.
기존 모델을 직접 학습하는 환경부터 준비하려면 Unsloth Studio로 로컬 학습 환경 시작하기를 참고하세요. 로컬 추론 흐름은 Unsloth로 DeepSeek를 로컬에서 실행하는 순서에서 이어 볼 수 있고, 의사결정 모델을 API로 실행하는 사례는 Unsloth Laya 로컬 실행 가이드에 정리되어 있습니다.
공식 X 게시물
Unsloth의 Qwen3.5-0.8B 세 벤치마크 및 4GB VRAM 발표입니다.
출처: X @UnslothAI
Laya를 2.5GB VRAM에서 추가 학습한 별도 사례입니다.
출처: X @UnslothAI