Cursor에서 한참 붙잡고 있던 프로젝트를 Codex로 옮기는 순간이 있습니다. 새 창을 열고 지난 작업을 처음부터 다시 설명해야 하죠. 텐센트가 이 번거로움을 줄이겠다며 오픈소스 Hy-Memory 2.0을 내놓았습니다.
AI를 바꿀 때마다 다시 설명하던 일, 이제 덜어 낼 수 있을까요
텐센트 훈위안은 여러 AI 에이전트가 기억을 나눠 쓸 수 있는 Hy-Memory 2.0을 공개했습니다. 공식 저장소에 따르면 Cursor에서 진행하던 프로젝트를 Codex로 옮겨도 이전 작업 내용을 다시 설명할 필요가 줄어듭니다.
핵심은 세 가지입니다. MemHub가 대화 내용, 작업 경험, 코드 수정 이력을 통합 관리합니다. 기억을 골라내고 정리하는 전용 모델 Hy-Memory-30B-A3B도 함께 나왔습니다. 그리고 이 모든 것이 오픈소스로 공개됐습니다.
공유 기억이라고 해서 기록을 통째로 넘기는 건 아닙니다
공유 기억이라는 말을 들으면 모든 AI가 같은 대화 기록을 통째로 읽는 그림이 떠오르기 쉽습니다. 그런데 공식 저장소를 열어 보면 그림이 조금 다릅니다.
MemHub는 로컬 우선 데스크톱·CLI 제품으로 소개됩니다. 사용자가 허가한 AI 앱의 대화 이력과 코딩 기록을 하나의 관리 런타임과 로컬 데이터 디렉터리로 모읍니다. 공식 설명은 로컬 우선 방식과 로컬 데이터 디렉터리에서의 통합 관리를 강조합니다. 다만 로컬 우선이 외부 전송이 전혀 없다는 보장을 뜻하지는 않습니다.
여기서 구분해 둘 것이 하나 있습니다. 기록을 연결하는 MemHub와, 무엇을 기억으로 남길지 고르는 모델은 서로 다른 역할입니다. 공유의 초점이 단순 복사에서 기억 관리로 옮겨 가고 있는 셈이죠.
대화와 코드는 서로 다른 방식으로 기억합니다
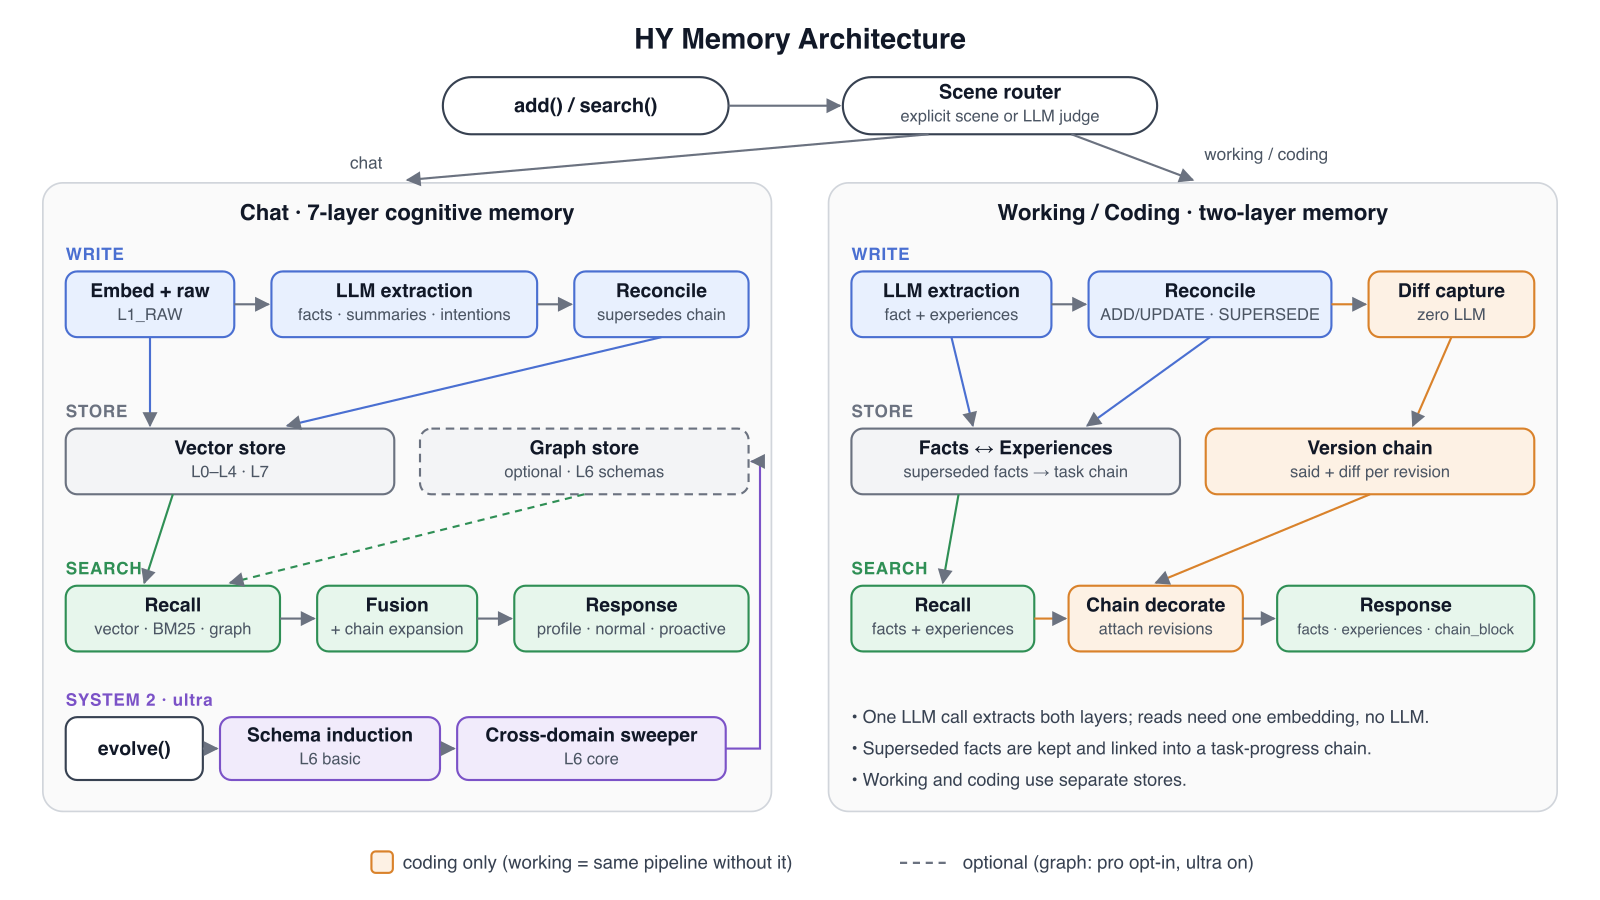
Hy Memory는 기억 엔진이자 Python SDK인 hy-memory로 제공됩니다. 작업의 성격에 따라 기억 방식도 나뉩니다.
| 작업 장면 | 기억 방식 |
|---|---|
| Chat (대화) | 계층형 장기 인지 기억 |
| Working (업무) | 사실과 재사용 가능한 경험의 두 계층 기억 |
| Coding (코딩) | 버전 변화의 차이를 잇는 추적 |
이 표를 보면 통합 관리가 모든 기록을 같은 형식으로 다룬다는 뜻은 아니라는 걸 알 수 있습니다. 대화는 맥락의 층을 쌓고, 업무는 사실과 경험을 나누고, 코드는 수정의 흐름을 따라갑니다. Chat·Working·Coding마다 기억을 처리하는 방식이 다르다는 점이 이번 공개에서 눈여겨볼 부분입니다.
여러 코딩 도구를 오간다면 연결 지점부터 보세요
공식 저장소는 MemHub가 연결할 수 있는 앱 예시로 Claude Code, Cursor, Codex, OpenCode, Qwen Code를 들고 있습니다. 이 목록을 직접 세면 5개입니다. 다만 이것은 예시로 든 앱의 수이고, 지원하는 전체 앱의 수는 아닙니다.
Cursor에서 Codex로 옮기는 상황이라면 살펴볼 지점은 두 가지로 좁혀집니다. 대화 이력이 어떻게 이어지는지, 그리고 코드 수정의 맥락이 어떻게 남는지입니다. 사용자의 승인을 거친 앱만 연결된다는 조건도 함께 기억해 두면 좋습니다. 기록이 자동으로 모든 도구에 퍼진다고 이해하면 실제와 어긋납니다. 연결하기 전에 공유할 앱, 프로젝트, 기록 범위를 먼저 정해 두는 것이 안전합니다.
얼마나 쌓느냐보다 무엇을 남기느냐가 관건이겠죠
이번 공개를 한 줄로 줄이면, 도구 사이의 맥락 이동과 기억 선별을 한데 묶은 시도입니다. 공식 설명이 대화·업무·코딩을 나눈다는 점이 중요한데, 공유 기억의 가치는 기록을 많이 모으는 데보다 작업마다 필요한 기억을 다르게 남기는 데 있다고 봅니다.
Cursor에서 Codex로 넘어갈 때 다시 설명하는 부담을 줄이겠다는 것이 Hy-Memory 2.0의 답입니다. 다음으로 지켜볼 것은 기록이 얼마나 쌓였는지가 아니라, 실제 도구를 옮길 때 필요한 작업 맥락이 얼마나 자연스럽게 이어지는지입니다.
참고 출처
- Tencent-Hunyuan Hy-Memory 공식 저장소: https://github.com/Tencent-Hunyuan/Hy-Memory