세 줄 요약
- effort는 Claude가 한 작업에 계산과 검증을 얼마나 쏟을지 정하는 신호이며,
/effort로 대화 중간에도 바꿀 수 있습니다. - Thariq는 스펙 인터뷰 → low 구현 → 검토 → high 검증 흐름을 쓰고, low를 훨씬 자주 사용합니다.
- 예외가 많은 보안·하드웨어·버그 수정은 effort를 올릴수록 나아지지만, 접근 방향이 틀린 실패는 effort만으로 잘 고쳐지지 않습니다.
Anthropic Claude Code 팀의 Thariq Shihipar는 effort 단계를 바꿔 같은 작업을 여러 번 시키고 결과와 소요 시간, 검증 과정을 비교했습니다. 결론은 늘 높은 단계를 쓰라는 게 아닙니다. 빠르게 함께 만들 때는 low, 방향이 잡힌 뒤 꼼꼼한 검증이 필요할 때는 high를 쓰는 식입니다.
출처: X @trq212 · 인터랙티브 설명과 실험 결과
1. effort는 “시간을 얼마나 줄지” 알려주는 신호
Thariq는 effort를 일을 맡길 때 주는 시간에 비유합니다. 누가 12시간을 통째로 주며 부탁하면, 받는 사람은 구석까지 파고들라는 뜻으로 읽습니다. 같은 일을 1시간 안에 해 달라고 하면, 요구를 채운 첫 버전부터 내밀고 그다음은 같이 고쳐 가면 된다고 여깁니다. 이 일은 최소 세 시간은 걸린다고 말하고 딱 세 시간을 채워 끝내는 사람도 있죠. effort도 똑같습니다. Claude는 어느 단계에서든 일을 제대로 하려고 하지만, 단계를 올리면 스스로 판단하고 검증하는 일이 늘어납니다.
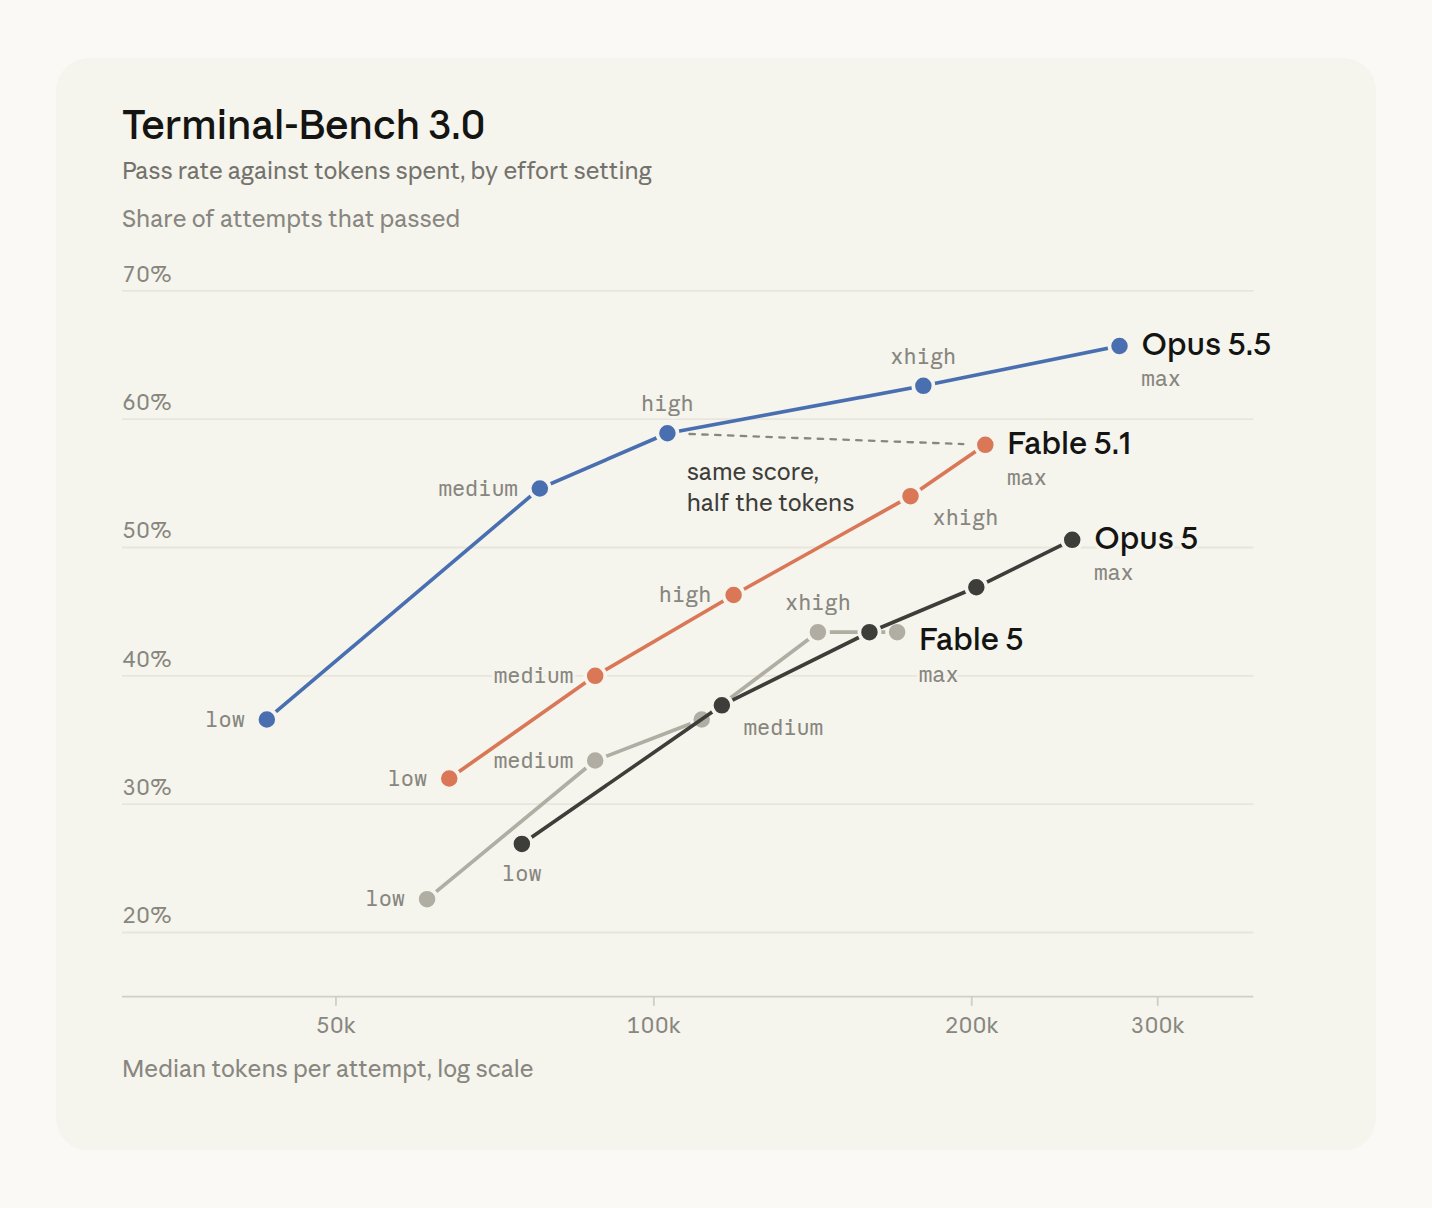
Thariq가 비교한 Fable 5.1과 Opus 5.5의 effort 곡선은 그가 지금까지 본 것 중 가장 좋았습니다. 단계가 올라갈수록 점수와 토큰 사용량이 함께 늘었고, Opus 5.5 high는 Fable 5.1 max와 비슷한 점수를 절반쯤의 토큰으로 냈습니다.
2. 같은 운동 앱, low 1분 반 vs max 67분
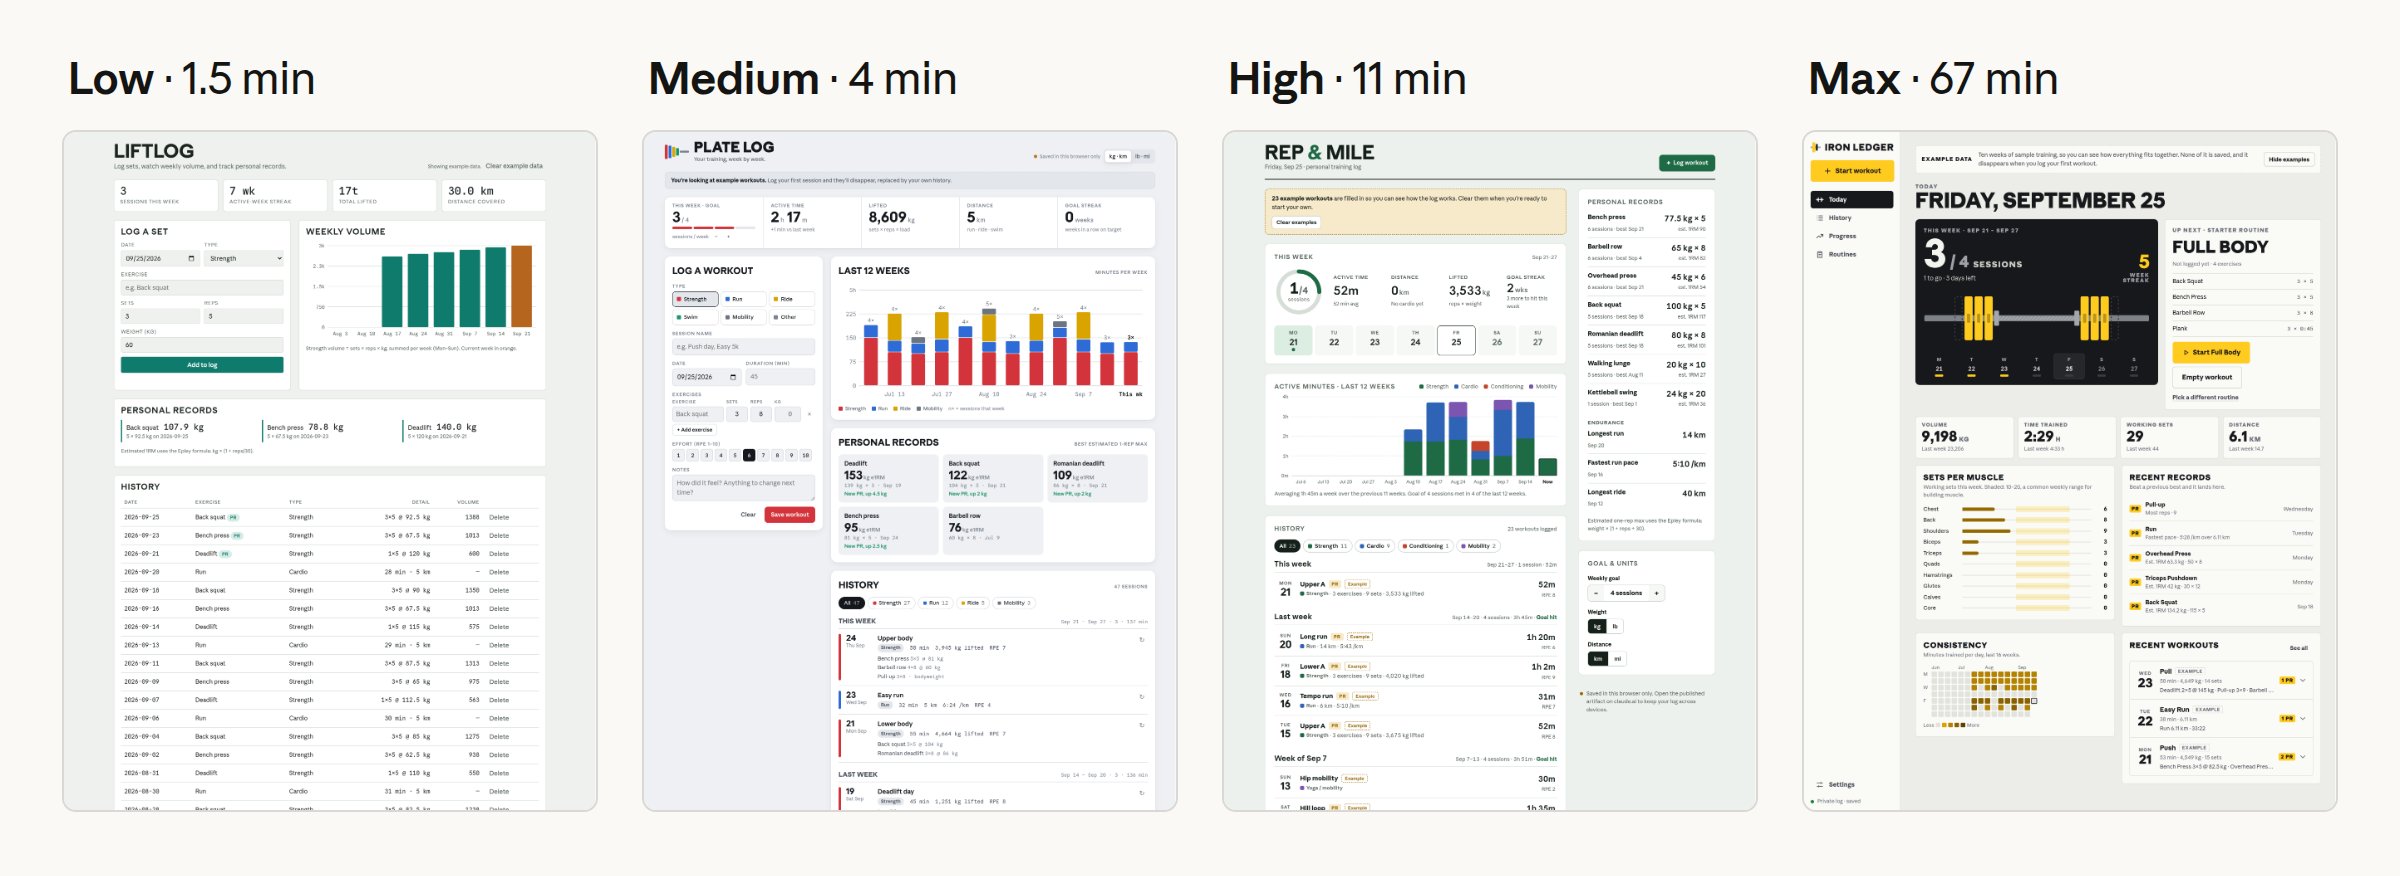
“개인 운동 기록 앱을 만들어줘”처럼 요구가 넓은 요청에서 low는 1분 반 만에 기록 기능과 그래프 하나를 만들었습니다. medium은 4분, high는 11분, max는 67분이 걸렸고 히트맵까지 갖춘 앱을 냈습니다. 사람이 이어서 손볼 초안은 low, 한 번에 가능한 완성도 높은 결과는 max가 알맞습니다.
3. 28분짜리 목업보다 1분짜리 스케치
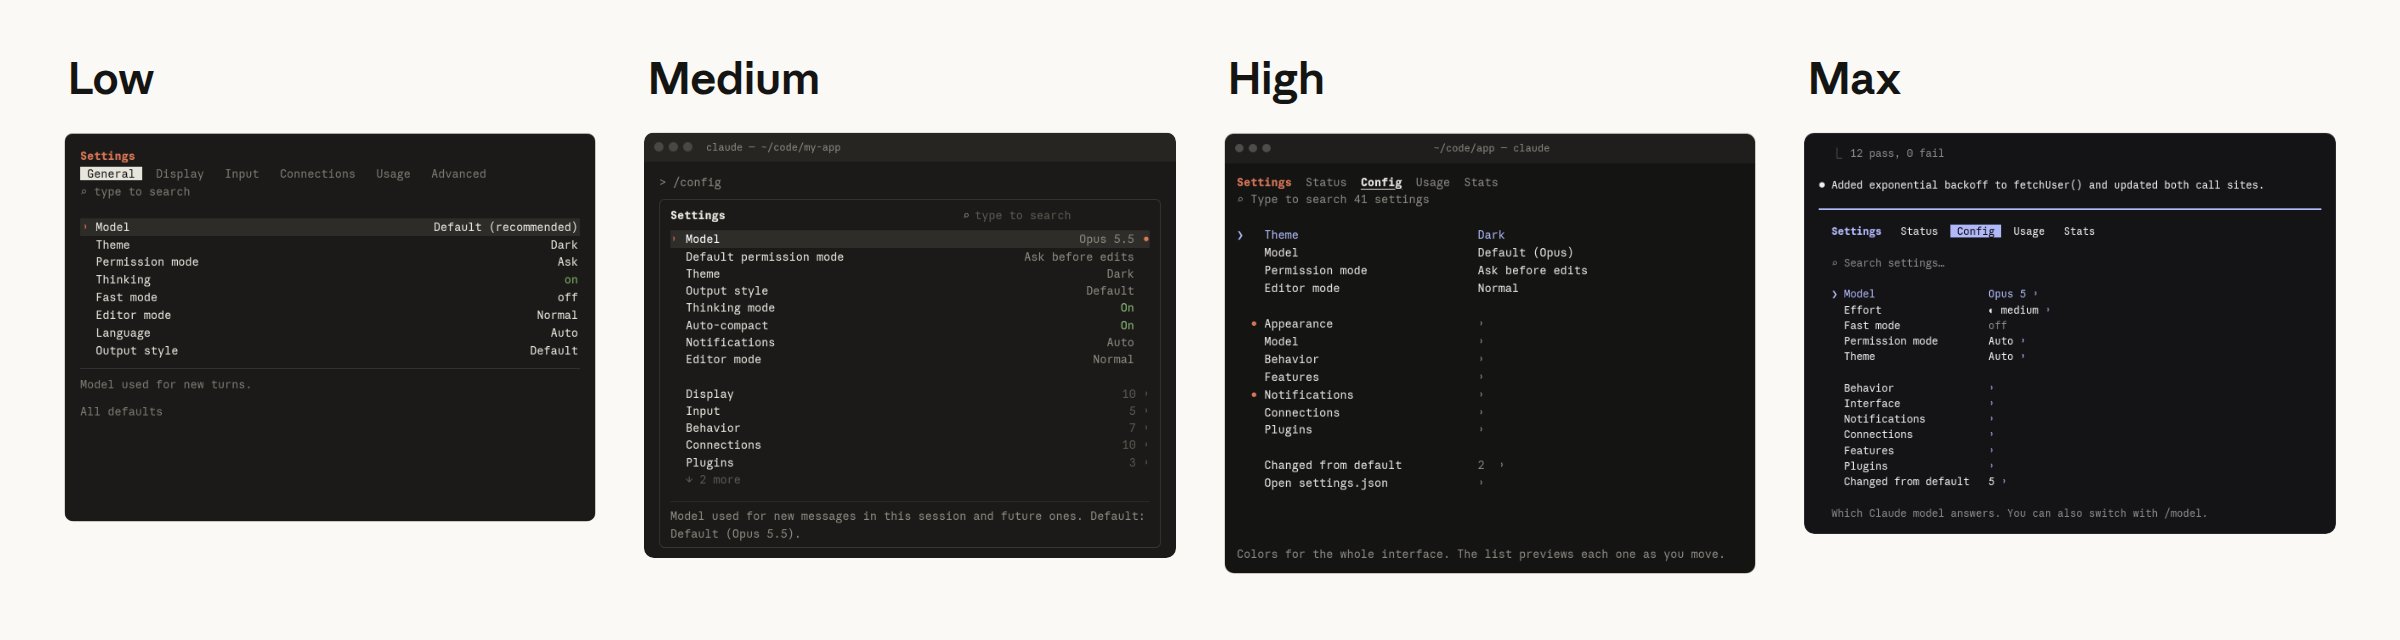
Claude Code /config 메뉴 재디자인에서는 하위 메뉴와 검색을 개선하자는 아이디어가 단계별로 비슷했습니다. low는 1분 만에 조작해 볼 스케치를 냈고 max는 28분 동안 Claude Code와 닮은 목업과 사용 흐름 설명을 만들었습니다. 빠른 피드백이 목적이라면 간단한 스케치가 더 유용했습니다.
4. 스펙을 꼼꼼히 주면 단계 차이가 줄어든다
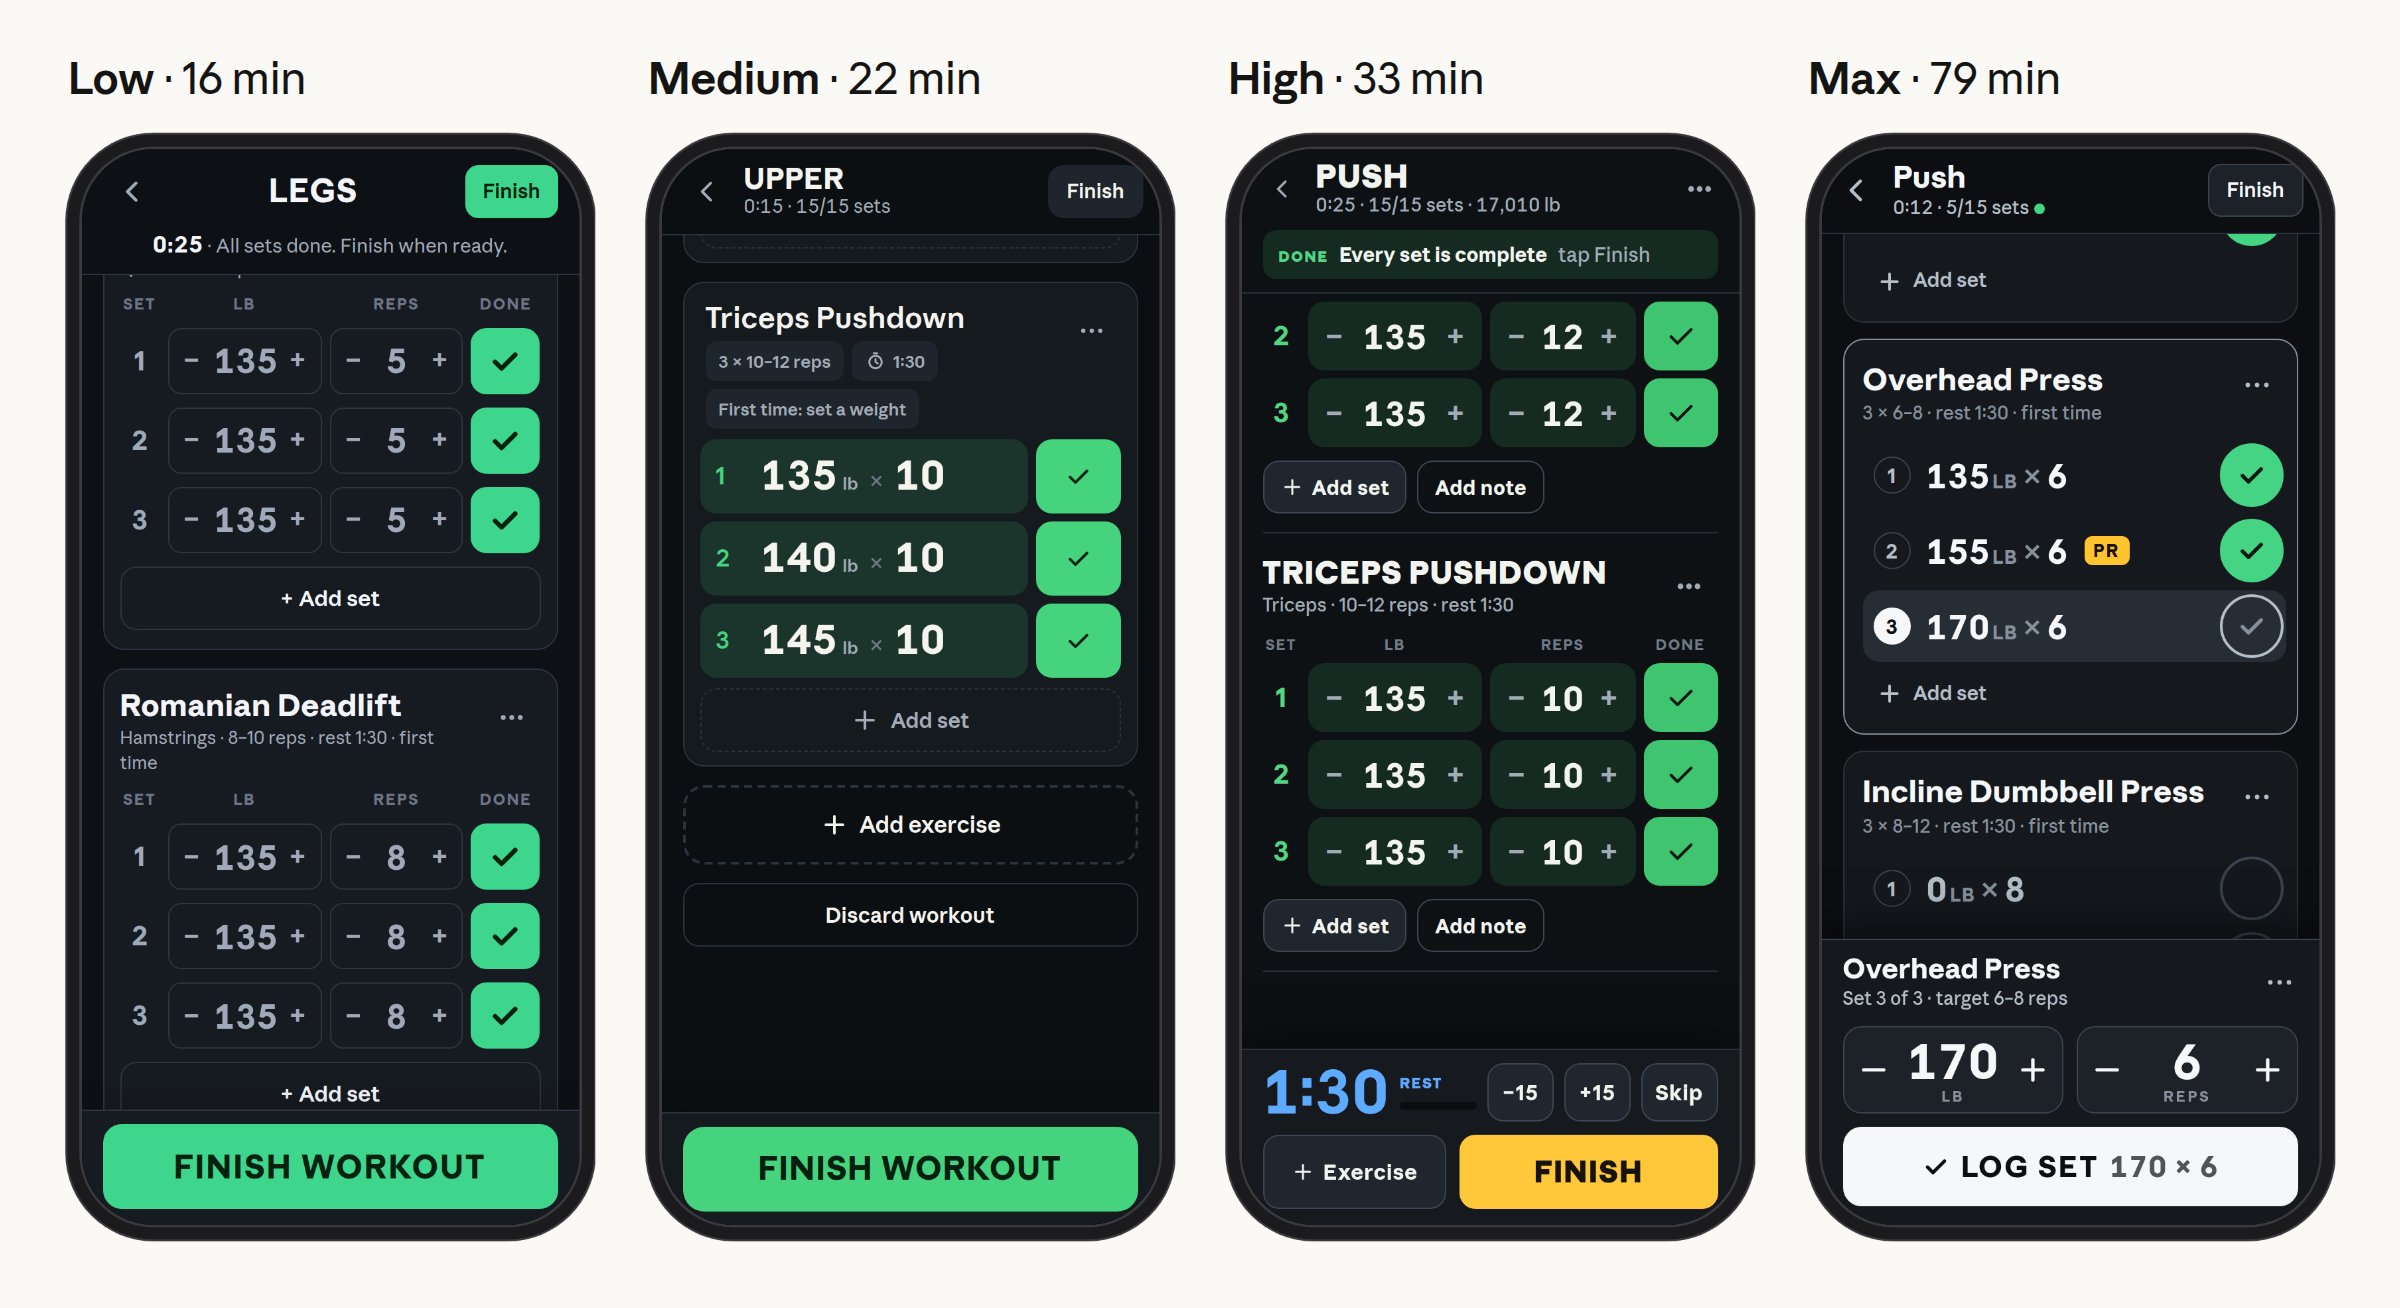
Claude가 먼저 질문해 빠진 요구사항을 채운 상세 스펙을 같은 운동 앱 과제에 전달하자 결과물은 서로 더 닮았습니다. low 16분, medium 22분, high 33분, max 79분이 걸렸고 max는 세부 표현을 다듬는 데도 시간을 썼습니다. 높은 effort가 하는 일의 큰 몫은 사람이 남긴 빈칸을 채우는 것입니다.
5. Thariq가 새 기능을 만드는 네 단계
- 스펙을 전달하고 비어 있는 세부사항은 Claude가 질문해 채우게 합니다.
/effort low로 첫 구현을 만듭니다.- 요구의 핵심을 잡았는지 확인하고 필요하면 low로 반복 수정합니다.
- 방향이 맞으면
/effort high로 검증과 테스트를 맡깁니다.
사람이 방향을 빠르게 잡아 주는 구간과 모델이 깊게 확인하는 구간을 나누면 상호작용이 효율적입니다.
6. 벤치마크 문제는 평소 업무보다 훨씬 크다
Terminal-Bench 3.0은 커뮤니티가 기여한 터미널 작업 벤치마크입니다. 보안, 하드웨어, ML, 과학, 소프트웨어, 운영, 미디어 문제를 다룹니다. v3.0.0 릴리스에는 초기 74개 태스크가 담겼습니다.
| 분야 | 태스크 | 요구 작업 |
|---|---|---|
| 하드웨어 | retro-console-soc | 작은 FPGA에 맞는 Verilog 8비트 게임 콘솔을 만들고 테스트 ROM 표시 |
| 과학 | takens-embedding-lean | Lean 4에서 Takens 임베딩 정리를 형식 증명 |
| ML | mp-checkpoint-consolidation | 16개 mixture-of-experts 체크포인트 조각을 합쳐 기준 logits 재현 |
| 운영 | intrastat-meldung | EU 월말 무역 통계 신고를 처음부터 처리 |
| 미디어 | layout-config-recreation | 포스터 이미지를 편집 가능한 레이아웃으로 재현 |
7. 2분짜리 필터와 33분짜리 필터
html-js-filter는 HTML에 JavaScript를 몰래 넣는 방법을 제거하는 과제입니다. Fable 5.1은 low에서 5번 중 1번, xhigh에서 5번 모두 통과했습니다. low는 약 2분 동안 필터를 한 번 작성하고 페이지 하나로 시험했습니다. 높은 effort 실행은 약 33분 동안 초안을 스스로 공격하듯 검토하고, 설치된 파서 소스에서 버그를 찾고, 표준 XSS 테스트와 직접 작성한 퍼저까지 사용했습니다. 보안 검토나 성능 최적화처럼 기준이 높은 일이라면 토큰을 이만큼 써도 아깝지 않습니다.
8. effort를 올려도 방향이 틀린 건 잘 안 고쳐진다
Fable 5.1 370회씩의 비교에서 토큰 중앙값은 73k→222k, 통과 횟수는 140→214였습니다. 실패 유형을 나누면 더 많이 확인하는 능력과 올바른 방향을 고르는 능력은 다릅니다.
| 실패 유형 | low | max |
|---|---|---|
| 예외 누락 실패 | 59 | 24 |
| └ 테스트가 놓친 버그 | 40 | 14 |
| 판단 오류 | 133 | 107 |
| └ 요구사항 오해 | 45 | 26 |
| └ 틀리거나 덜 된 수정 | 31 | 10 |
| └ 도메인 규칙 오류 | 32 | 24 |
| └ 잘못된 해석 선택 | 25 | 47 |
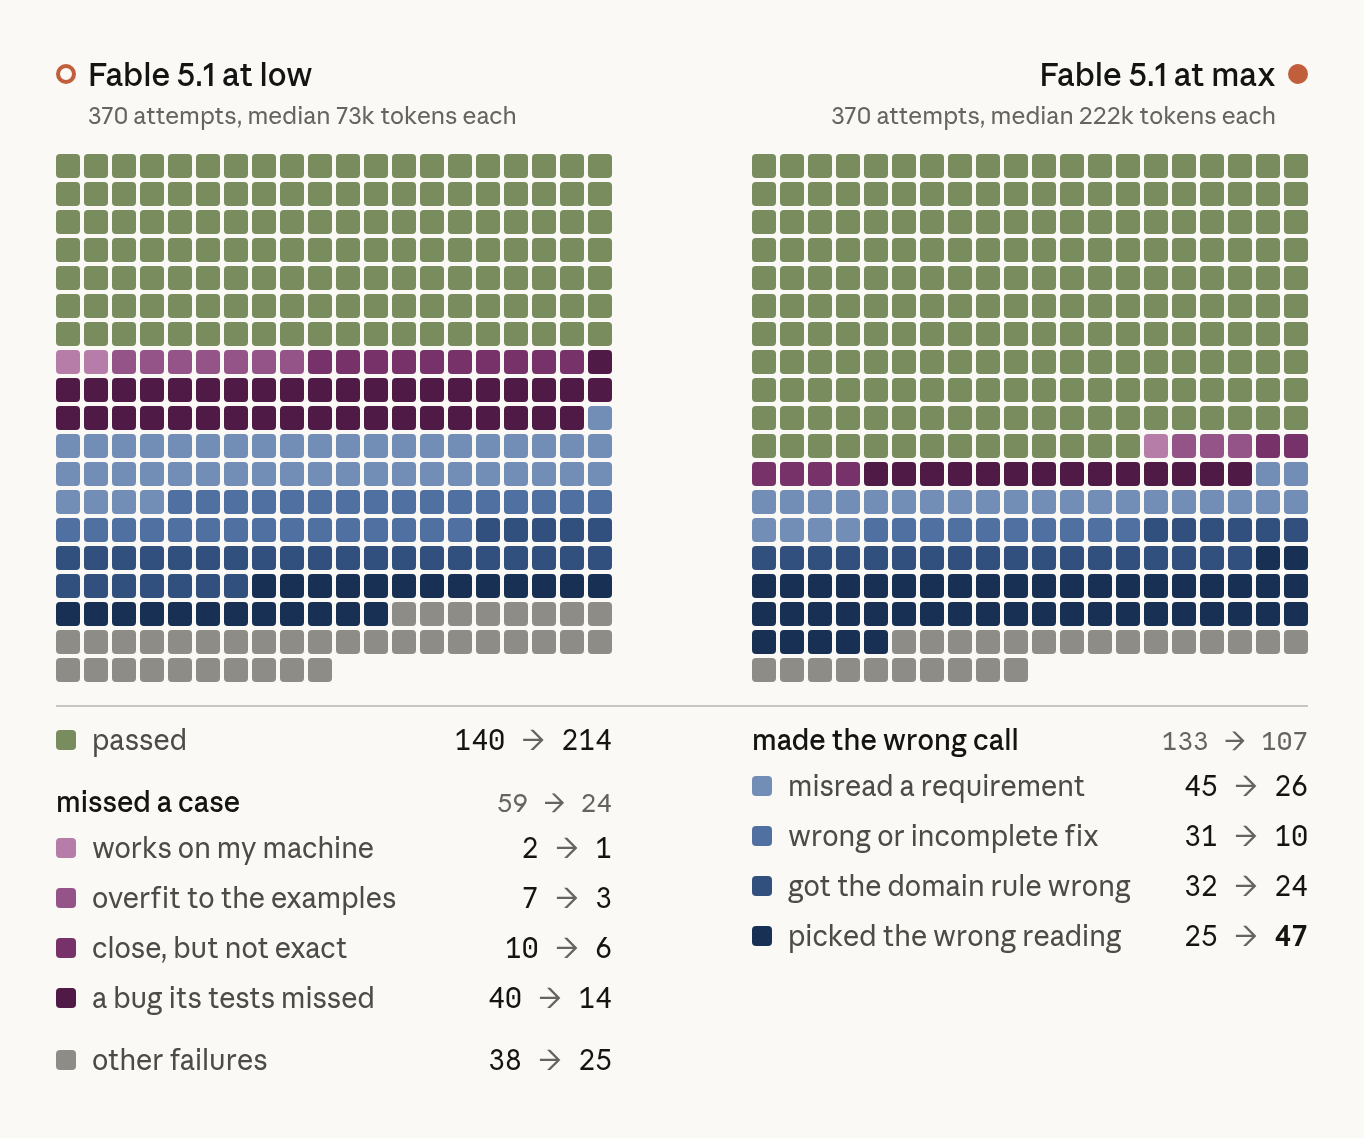
예외 누락은 줄었지만 잘못된 해석 선택은 25회에서 47회로 늘었습니다. 높은 effort는 더 꼼꼼하게 확인할 수 있어도 방향까지 대신 정해 주지는 않습니다. 인터뷰로 목표와 제약을 먼저 맞추는 이유입니다.
9. 하드웨어 34% → 75%: 어려운 분야에서 effort 효과가 크다
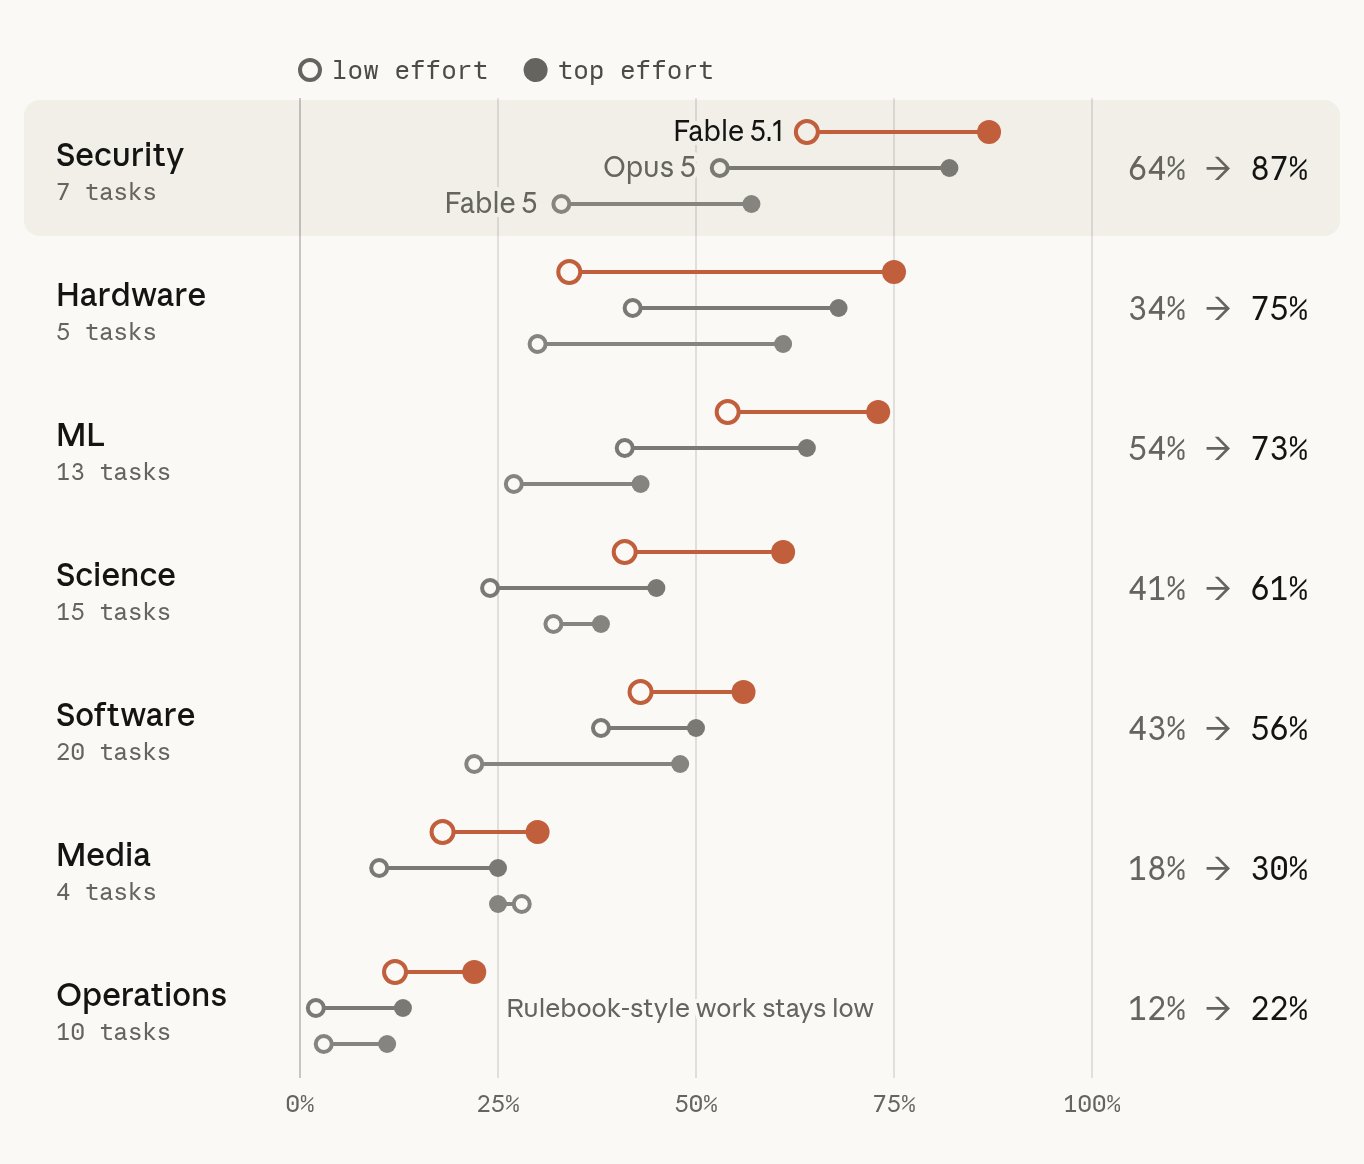
Fable 5.1의 분야별 통과율은 low에서 최고 effort 단계들로 갈수록 하드웨어 34%→75%, 보안 64%→87%, ML 54%→73%, 과학 41%→61%, 소프트웨어 43%→56%, 미디어 18%→30%, 운영 12%→22%였습니다. 운영처럼 정해진 규칙을 따르는 문제는 여전히 낮았습니다.
저장 엔진 버그 mvcc-lsm-compaction에서 Opus 5.5 low는 빌드와 재현 전에 코드를 수정해 약 1분 만에 끝났고 0/5였습니다. xhigh는 약 11분 동안 충돌을 먼저 재현하고, 덜 고친 코드에서 테스트가 실패하는지 확인해 4/5를 통과했습니다.
10. 물어볼 사람이 없으면 high는 두 번 해본다
선형계획 풀이기 cli-2ph-simplex에서 low는 1만 토큰 근처에서 멈추며 큰 입력에서 느릴 수 있다고 경고했습니다. high는 큰 문제의 실행 시간을 재고 탐색 방법을 바꿔 0/5에서 5/5로 올라갔습니다.
단백질 분석 gsea-proteomics에서는 high가 두 전처리 방법을 비교하다 결과 차이를 알아채고 맞는 방법을 골라 0/5에서 4/5가 됐습니다. 사람이 있으면 선택을 물어볼 수 있지만, 혼자 진행해야 할 때는 high가 두 접근을 시험해 보는 편이 나을 수 있습니다.
11. Thariq는 max를 사실상 두 경우에만 쓴다
그는 low를 훨씬 자주 쓰고, max는 입력을 거의 주지 않고 자율적으로 맡기거나 보안 취약점을 찾을 때 씁니다.
| 단계 | 잘 맞는 작업 |
|---|---|
| low | 브레인스토밍, 스케치, 쉬운 수정 |
| medium | 새 기능 등 대부분의 일상 개발 |
| high | 검증이 중요하거나 예외가 많은 작업, 오래된 코드 버그 수정 |
| max | 처음부터 자율적으로 만들고 검증하기, 중요한 소프트웨어 보안 취약점 찾기 |
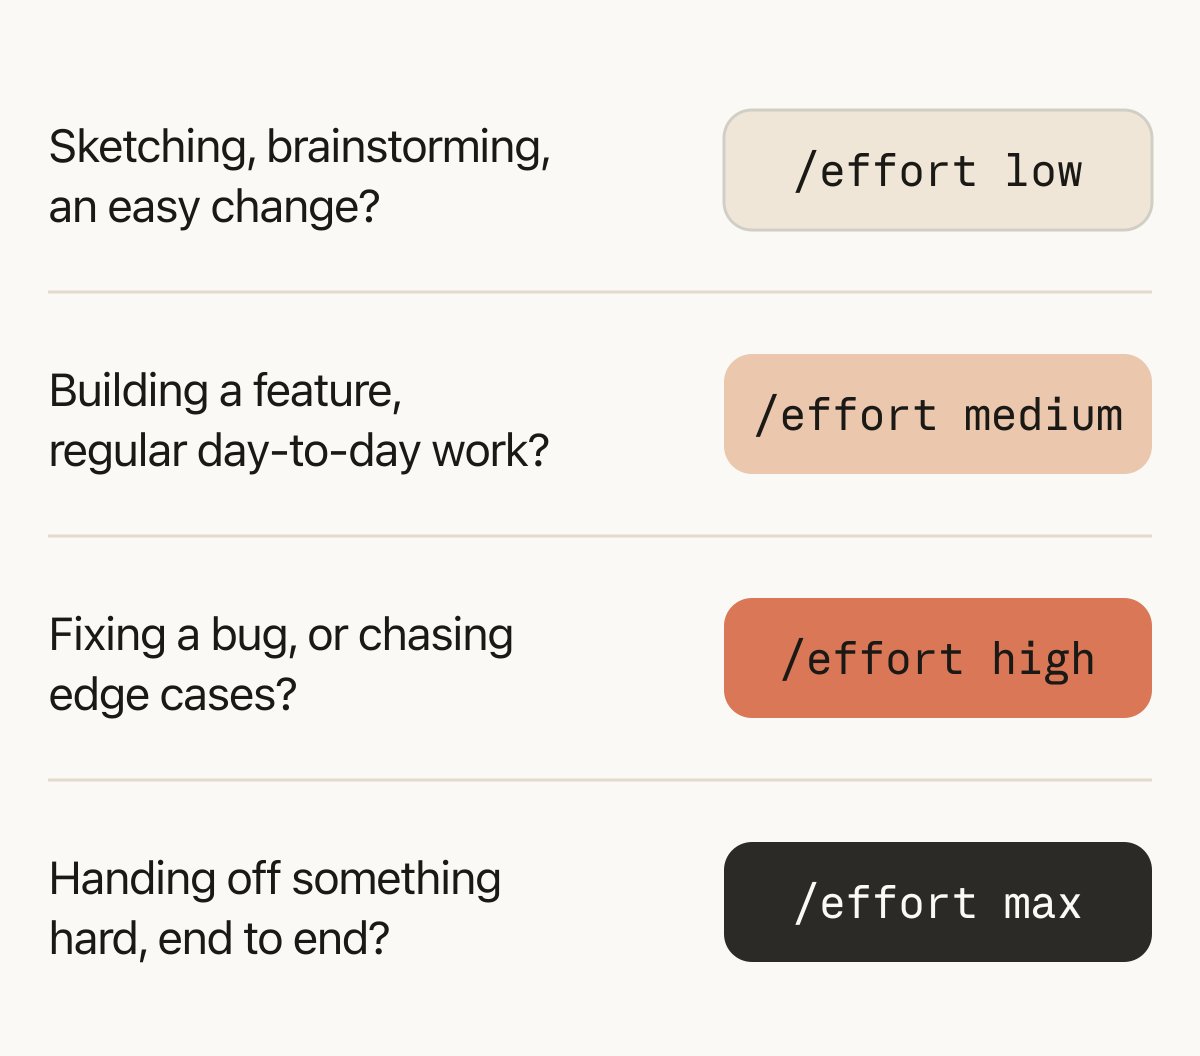
출처: X @trq212 · low를 훨씬 자주 쓰고, max는 입력을 전혀 주고 싶지 않거나 보안 취약점을 찾을 때만 사용한다는 설명입니다.
Claude Code에서 effort 바꾸는 법
/effort low, /effort medium, /effort high, /effort xhigh, /effort max로 설정합니다. /effort auto는 모델 기본값으로 돌아갑니다. 인자 없이 /effort를 입력하면 슬라이더가 열리며 좌우 화살표로 선택하고 Enter를 누르면 됩니다. max는 해당 세션에만 적용됩니다.
계속 사용할 값은 settings.json의 effortLevel로 설정할 수 있습니다. 환경 변수 CLAUDE_CODE_EFFORT_LEVEL도 가능하며 환경 변수가 가장 우선합니다. 모델마다 지원 단계가 다를 수 있습니다. 최신 모델은 대화 중간에 단계를 바꿔도 프롬프트 캐시가 깨지지 않습니다.
Claude Code commands · interactive mode · environment variables
다음 작업 하나로 시험해 보기
다음 작업 하나를 /effort low로 시작해 보세요. 결과물의 방향이 맞으면 /effort high로 올려 테스트를 맡기면 됩니다.