3줄 요약
- Unreal Agent는 모델이 도구 실행을 기다리며 폴링하지 않도록 만든 오픈소스 에이전트 하네스입니다.
- 도구는 백그라운드에서 실행되고, 모델은 그 사이 다른 작업을 진행하거나 사용자의 추가 지시를 받을 수 있습니다.
- Unreal Labs는 GPT-6 Astra xhigh 벤치마크에서 Codex 대비 최대 40%, Pi 대비 최대 20% 비용 절감을 보고했습니다.
에이전트 비용을 낮추려면 보통 더 저렴한 모델을 찾습니다. Unreal Labs는 같은 모델을 사용하면서 실행 뼈대인 하네스를 바꿔 Codex 대비 최대 40%, 또 다른 오픈소스 하네스 Pi 대비 최대 20% 낮은 비용을 기록했다고 발표했습니다. 하네스는 모델과 도구, 대화 기록, 사용자 메시지를 이어 주는 실행 환경입니다.
Unreal Labs는 이를 “up to 40% cost savings compared to Codex ... without any negative performance impact”라고 소개했습니다. 성능 저하 없이 Codex 대비 최대 40% 비용을 절감했다는 뜻입니다. 출처: X @unreallabsai
기존 에이전트는 도구가 끝날 때까지 기다린다
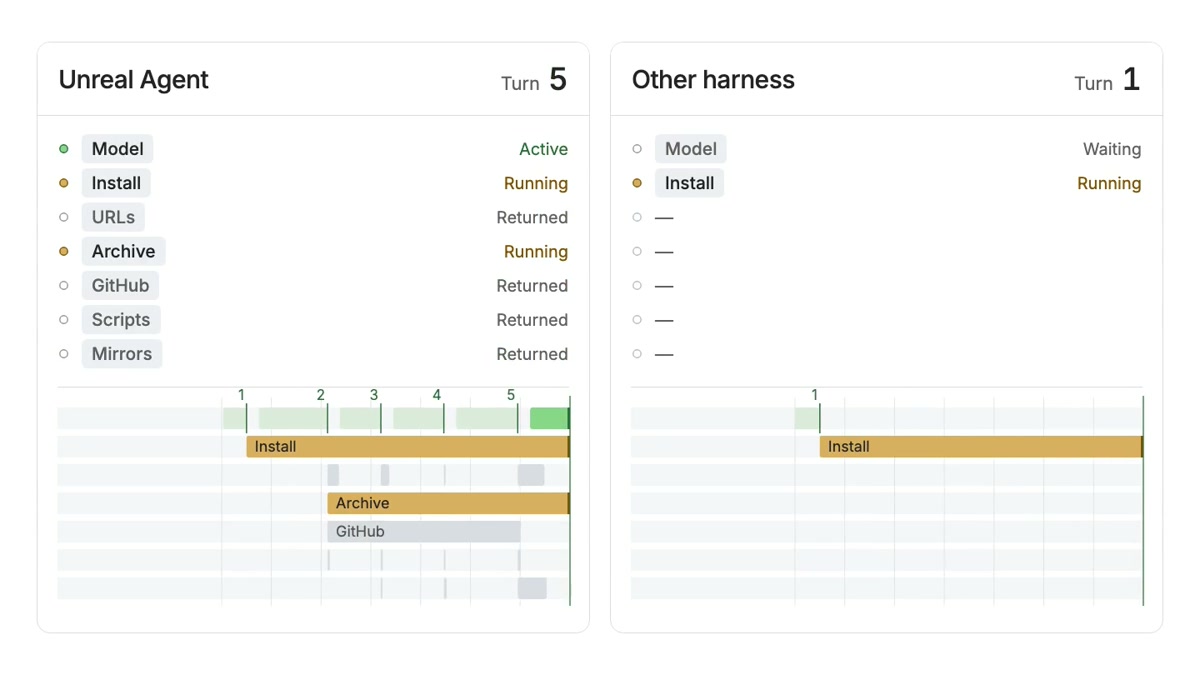
에이전트가 개발 환경 설치처럼 몇 분 걸리는 명령을 실행하면, 모델은 작업이 끝났는지 확인하기 위해 기다리거나 상태를 반복해서 물을 수 있습니다. 그동안 코드 탐색이나 웹 검색을 함께 시키기 어렵고, 대기와 폴링에도 모델 턴과 토큰이 들어갑니다. Unreal Labs는 설치가 도는 동안 다른 작업을 병렬로 진행하고 싶었던 문제에서 출발했습니다.
도구 호출을 비동기로 처리하는 방법
- 모델이 도구 호출을 요청합니다.
- 하네스는 해당 호출을 ‘진행 중’ 상태로 세션 이벤트 로그에 바로 기록합니다.
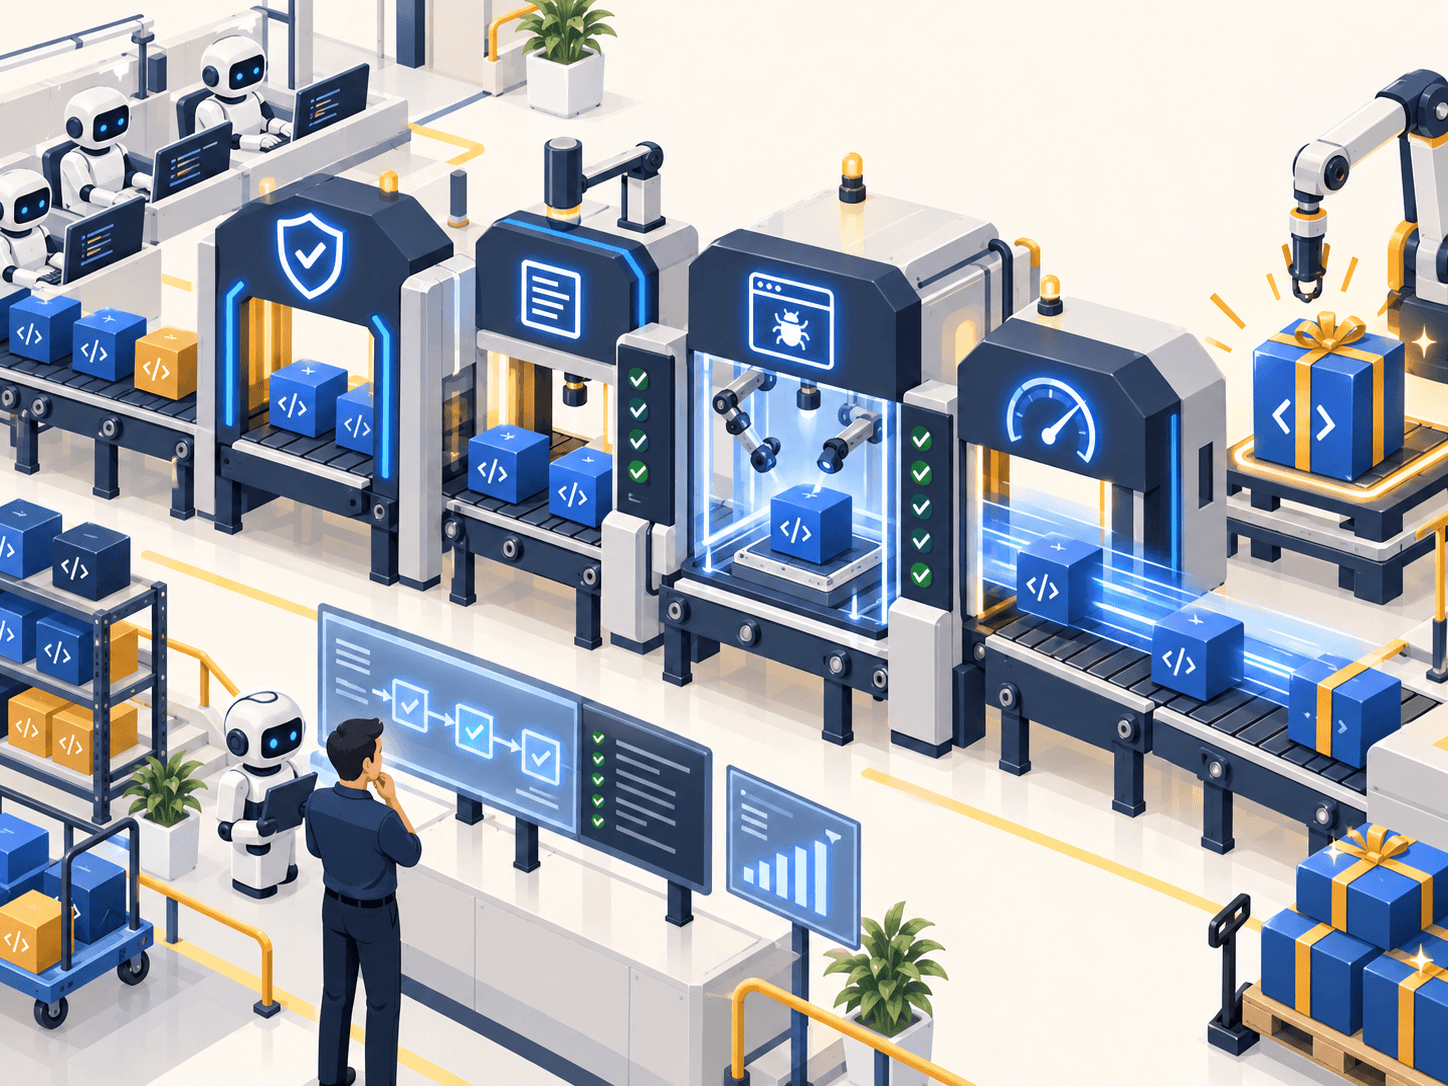
- 도구는 모델 호출 바깥에서 백그라운드로 실행되고, 다른 도구도 함께 진행할 수 있습니다.
- 작업이 끝나면 최종 결과를 로그에 붙이고 모델을 다시 호출합니다.
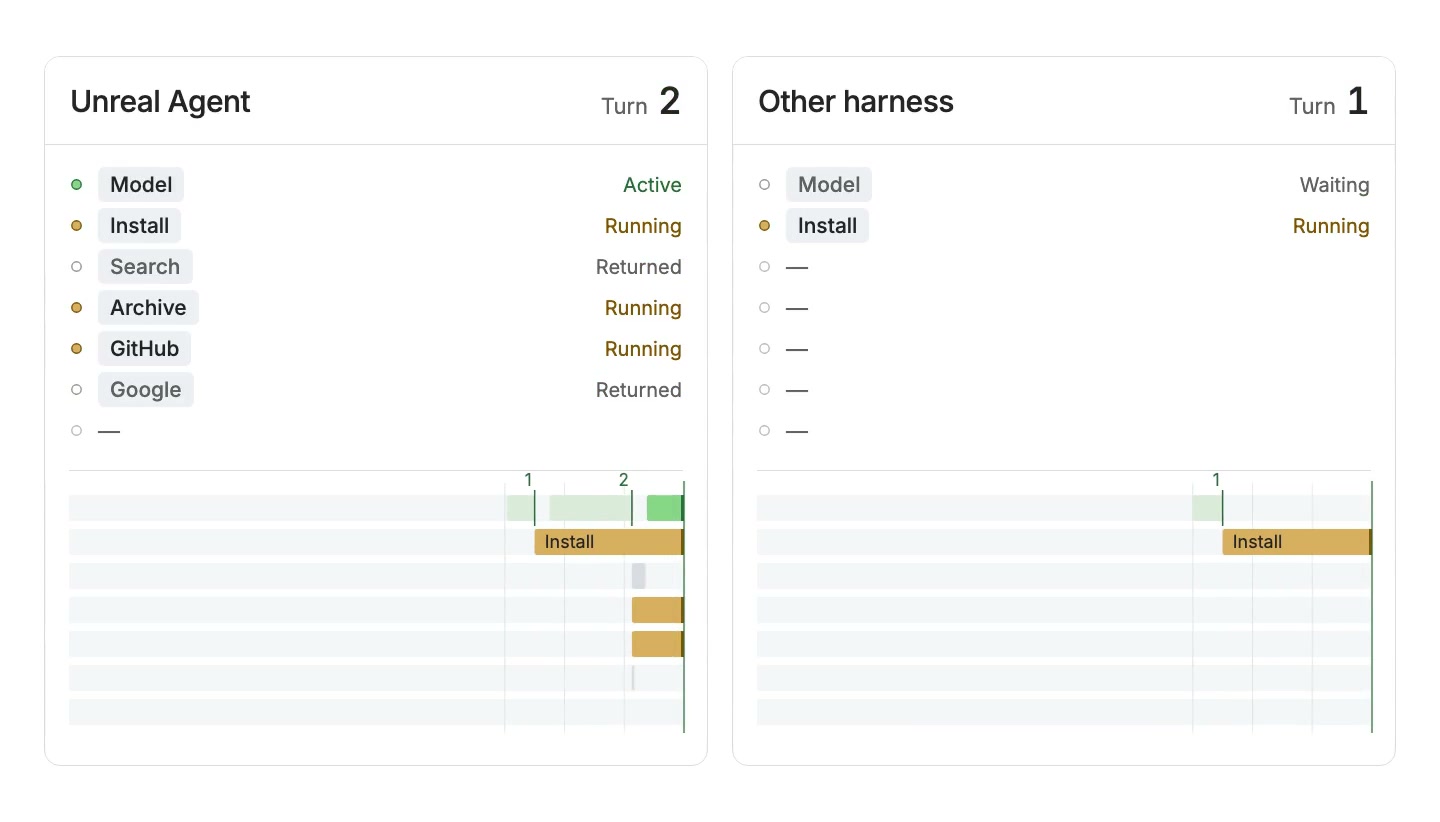
진행 중 결과와 최종 결과를 한 대화에 함께 남기면서 모델 입력의 캐시를 유지하는 것이 구현 과제였습니다. 공식 글의 각주에서는 이 메시지 형식이 Responses API 문서에 명확히 규정돼 있지 않았고, 일부 다른 추론 제공자가 형식을 거부하기도 했다고 설명합니다. 형식이 받아들여진 경우 모델은 진행 중 상태가 나중에 완료되는 흐름을 이해했습니다.
사용자가 개입하고, 모델은 더 많은 일을 한다
도구가 백그라운드에서 도는 동안에도 사용자는 에이전트에게 새 지시를 보낼 수 있습니다. 실행 구조가 기다림과 상태 확인을 맡으므로 모델은 다음 호출 사이에 코드 탐색이나 다른 도구 작업을 더 배치할 수 있습니다.
Unreal Labs가 든 비용 절감 요인은 두 가지입니다. 하네스는 단순한 프롬프트와 토큰을 아끼는 도구 결과를 사용하고, 서브에이전트나 별도 워크플로를 두지 않아 자체 오버헤드를 낮춥니다. 여기에 비동기 도구 실행으로 모델 턴 사이에 더 많은 작업을 처리해, 대기·폴링에 드는 턴과 입력 토큰을 줄입니다.
벤치마크에서 보고한 비용 차이
Unreal Labs는 GPT-6 Astra xhigh로 네 가지 코딩 벤치마크를 평가했습니다. 아래 비용은 각 표의 총비용이며, 통과율과 함께 원문 수치를 옮겼습니다.
| 벤치마크 | Unreal Agent | Codex | Pi | 입력 토큰·턴 (Unreal / Pi) |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% · $1,428 | 57.9% · $2,350 | 55.0% · $1,827 | 1.73M / 2.83M · 28 / 44 |
| SWE-Atlas Codebase QnA | 65.8% · $936 | 63.3% · $1,303 | 64.0% · $1,033 | 898k / 1.29M · 16 / 24 |
| DeepSWE 1.1 | 72.4% · $1,367 | 69.0% · $1,633 | 69.6% · $1,584 | 1.60M / 2.21M · 26 / 40 |
| Agents’ Last Exam · ALE-CLI | 30.0% 완전 통과 · $217 | 29.0% · $292 | 29.0% · $262 | 0.76M / 1.19M · 18 / 27 |
공식 X 비교 이미지가 제시한 Codex 대비 절감률은 Terminal-Bench 39%, SWE-Atlas 28%, Agents’ Last Exam 26%, DeepSWE 16%입니다. Terminal-Bench의 Codex 수치는 같은 조건에서 새로 실행한 값이 아니라 리더보드 기준선입니다. Unreal Labs는 통과율의 작은 차이를 벤치마크 변동으로 설명하며, 실행 기록은 Harbor에서 공개해 재실행할 수 있도록 했습니다.
출처: X @unreallabsai
Go 러너로 실행하기
Unreal Agent는 Go 라이브러리, claude -p나 codex exec처럼 명령 한 줄로 실행하는 러너 실행 파일, Harbor 호환 벤치마크 러너 세 가지 형태로 제공됩니다. 러너는 Go 1.27 이상을 요구하며 OpenAI를 기본 제공자로 사용합니다.
go install github.com/unreallabsai/unreal-agent/cmd/unreal-agent-runner@latest
export OPENAI_API_KEY="..."
unreal-agent-runner -p 'Inspect this project and explain how to run its tests.'
작업 디렉터리를 지정하고 실행 기록을 JSONL 파일로 저장할 수 있습니다.
unreal-agent-runner -workspace ./my-project -p 'Summarize this project.' > run.jsonlUNREAL_HARNESS_LLM_PROVIDER로 openai, openai-codex, openrouter, fireworks, ollama를 선택하고 UNREAL_HARNESS_LLM_MODEL로 모델을 지정합니다. Harbor 벤치마크 러너는 Python 3.12 이상, uv와 Docker 또는 Modal이 필요합니다. 저장소의 Harbor 안내는 다음처럼 빌드하고 실행합니다.
make -C benchmarks/harbor sync
make -C benchmarks/harbor build REVISION=HEAD
export OPENAI_API_KEY=...
uv run --project benchmarks/harbor --locked harbor run \
  -p /absolute/path/to/task \
  -a harness_harbor.agent:UnrealAgent \
  -m openai/gpt-5.4 \
  --ak bundle="$PWD/bin/harbor/<short-commit>" \
  --ak thinking_level=high
왜 기존 에이전트 SDK 대신 직접 만들었나
Unreal Labs는 CLI 중심 SDK가 로컬 세션과 자식 프로세스를 전제해, 제품 환경에서 작업 완료·취소·백그라운드 실행의 생명주기를 별도로 다뤄야 했다고 설명합니다. 제공자를 바꾸거나 SDK가 업데이트될 때 메시지 형식과 도구 호환성을 유지하는 부담도 이유로 들었습니다. 보안과 승인은 하네스 훅보다 허용 호스트, 세분화된 토큰, 승인 프록시처럼 실행 환경의 제약으로 관리한다는 설계입니다.
에이전트 비용은 실행 구조도 결정한다
Unreal Agent가 보여주는 관점은 모델 가격표만으로 에이전트 비용을 판단하기 어렵다는 것입니다. 같은 모델이라도 대기와 폴링을 줄이고 도구 작업을 알맞게 배치하면 토큰 지출을 줄일 수 있습니다. Unreal Labs는 하네스 설계를 별도의 연구 분야로 보고 있으며, 관련 참고 자료로 HarnessTax: How Much Does Harness Matter for Coding Agents?를 소개합니다.