AI한테 밀려나는 회계사. 회계사가 Claude와 함께 푼 결과가 Claude 혼자 푼 결과보다 느리고 정확도도 조금 낮았습니다. 머코어 실험에서 회계사들은 Claude의 맞는 조언을 뒤집거나, Claude가 잘못 고친 숫자를 그대로 받아들였는데요. 3시간을 준 월말 결산 과제에서 AI는 10분 안에 만점을 받았고, 비용은 회계사 인건비의 49분의 1이었습니다.
미국 공인회계사 12명과 AI가 같은 결산 과제를 풀었습니다
AI 학습 데이터 기업 머코어(Mercor)가 10월 2일(한국 시간) 미국 공인회계사 12명과 AI 모델에게 같은 회계 과제를 풀게 한 연구를 블로그와 논문으로 공개했습니다. 참가자는 모두 현직 미국 공인회계사였고 평균 회계 경력은 5.4년이었습니다. 절반은 빅4 회계법인에서 일한 경험이 있었습니다.
분량이 중간 정도이고 요구사항이 분명한 회계 업무에서 최신 AI는 회계사보다 빠르고 정확했으며, 가장 높은 점수를 받은 참가자도 앞섰습니다. 결과가 잘못 해석될 가능성을 고려해 공개하지 않는 방안도 검토했지만, 사람들이 AI에 대비하려면 결과를 공개하는 편이 맞다고 판단했습니다.
연구 논문 PDF와 머코어의 연구 소개에서 실험과 결과를 확인할 수 있습니다.
출처: X @mercor
과제마다 3시간, 채점 항목은 13~22개였습니다
과제는 머코어가 7월에 공개한 APEX-Accounting에서 가져와 사람이 3시간 안에 풀 수 있도록 줄인 월말 결산 업무 네 가지였습니다. 참가자는 가상 회사 업무 파일이 들어 있는 가상 PC에서 과제마다 최대 3시간 동안 작업했습니다. 회계사가 직접 만든 채점 기준은 과제마다 13~22개 항목으로 이뤄졌습니다.
첫 과제는 비영리단체의 공통비용을 프로그램과 지원 부서에 배분하고 12월 지출을 예산과 비교하는 일이었습니다. 두 번째는 호텔 예약 시스템과 장부의 12월 객실 매출 및 온라인 여행사 수수료 차이를 조정하는 과제였습니다. 예를 들어 주차 수입 4,000달러가 객실 매출로 잘못 분류된 항목을 찾아야 했습니다.
세 번째는 행사장 매출을 행사 유형별로 집계해 예산과 비교하는 일이었고, 네 번째는 그룹사 세 곳의 리스 스케줄을 갱신해 12월분 리스 자산과 부채를 반영하는 과제였습니다.
회계사 평균 37%, Opus 5는 20번 모두 만점
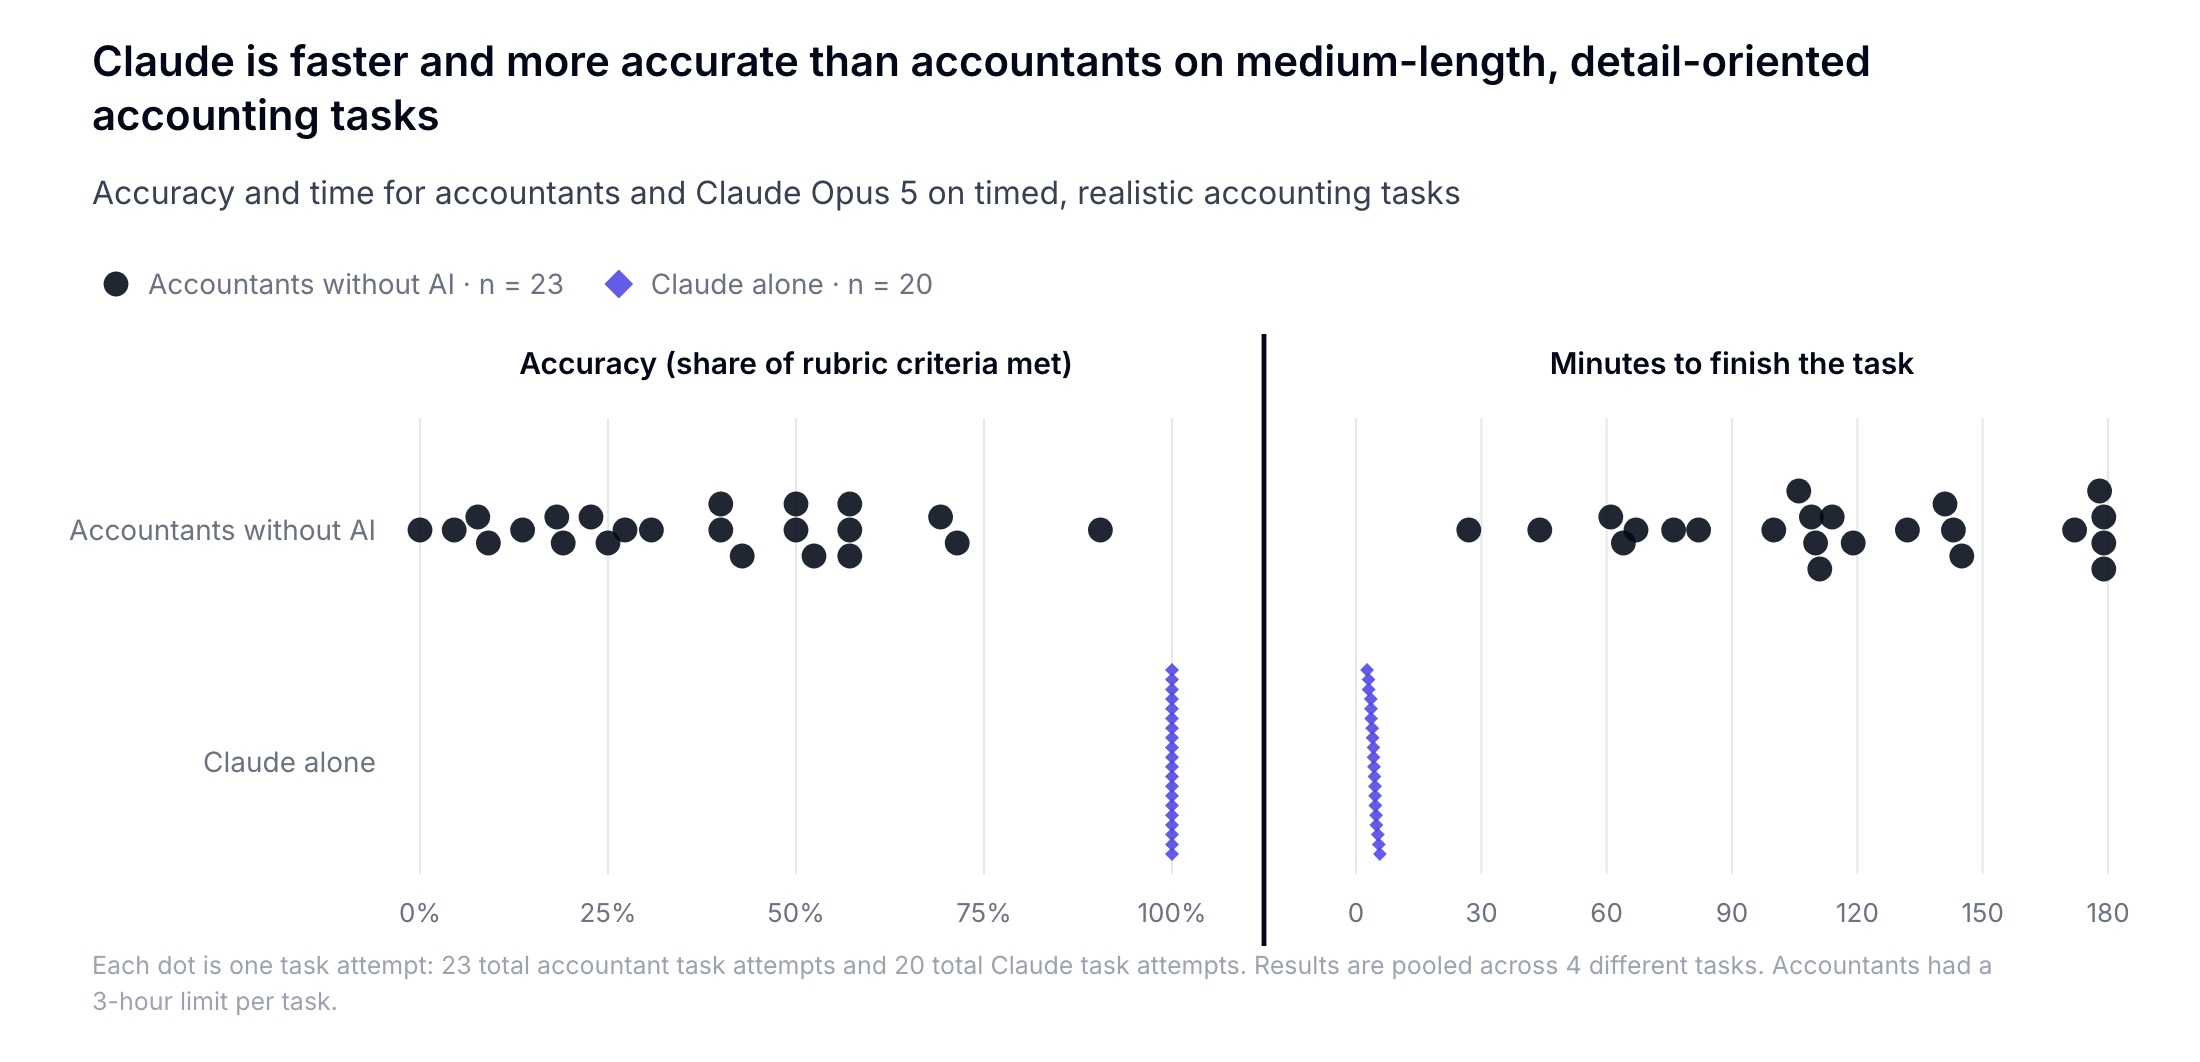
AI 없이 과제를 푼 회계사의 23회 시도는 0%에서 90% 안팎까지 분포했고 평균 점수는 37%였습니다. 대부분 30분에서 3시간을 사용했습니다. 같은 파일과 기준으로 혼자 푼 Claude Opus 5는 20회 모두 100%를 받았고, 매번 10분도 걸리지 않았습니다.
과제를 만든 회계사들은 주니어 회계사의 평균 점수를 30%, 중간급 회계사는 55%로 예상했습니다. 참가자 대부분은 3시간이 되기 전에 제출했습니다. 시간이 부족해 낮은 점수를 받은 경우는 많지 않았습니다.
점수 차이는 최근 모델이 갑자기 나타난 것이 아니라 약 18개월 동안 빠르게 좁혀 온 결과입니다. GPT-4o는 2024년 중반 이 과제에서 0%에 가까웠고, 2025년 봄에는 OpenAI o3가 회계사 평균 37%를 처음 넘어섰습니다. GPT-5는 약 69%, Opus 4.8은 80% 안팎이었으며 Opus 5와 최신 프런티어 모델은 100%에 가까웠습니다. Claude Opus 5가 다른 모델 평가에서 기록한 성과도 소개한 바 있습니다.
머코어는 18개월 전에 같은 실험을 했다면 평균적인 참가자가 AI를 이겼겠지만, 지금은 가장 잘한 참가자도 크게 뒤처진다고 봤습니다. Qwen3.5-122B처럼 비용이 낮거나 공개 가중치를 제공하는 일부 모델은 아직 회계사 평균보다 낮았습니다.
출처: X @aden_barton
Claude와 함께 풀었더니 시간은 약 15배 걸렸습니다
처음 설계한 연구의 목적은 AI가 회계사를 얼마나 도울 수 있는지 측정하는 것이었습니다. 참가자는 네 과제 중 무작위로 정해진 두 과제를 Claude Cowork(Opus 5)와 함께 풀었습니다.
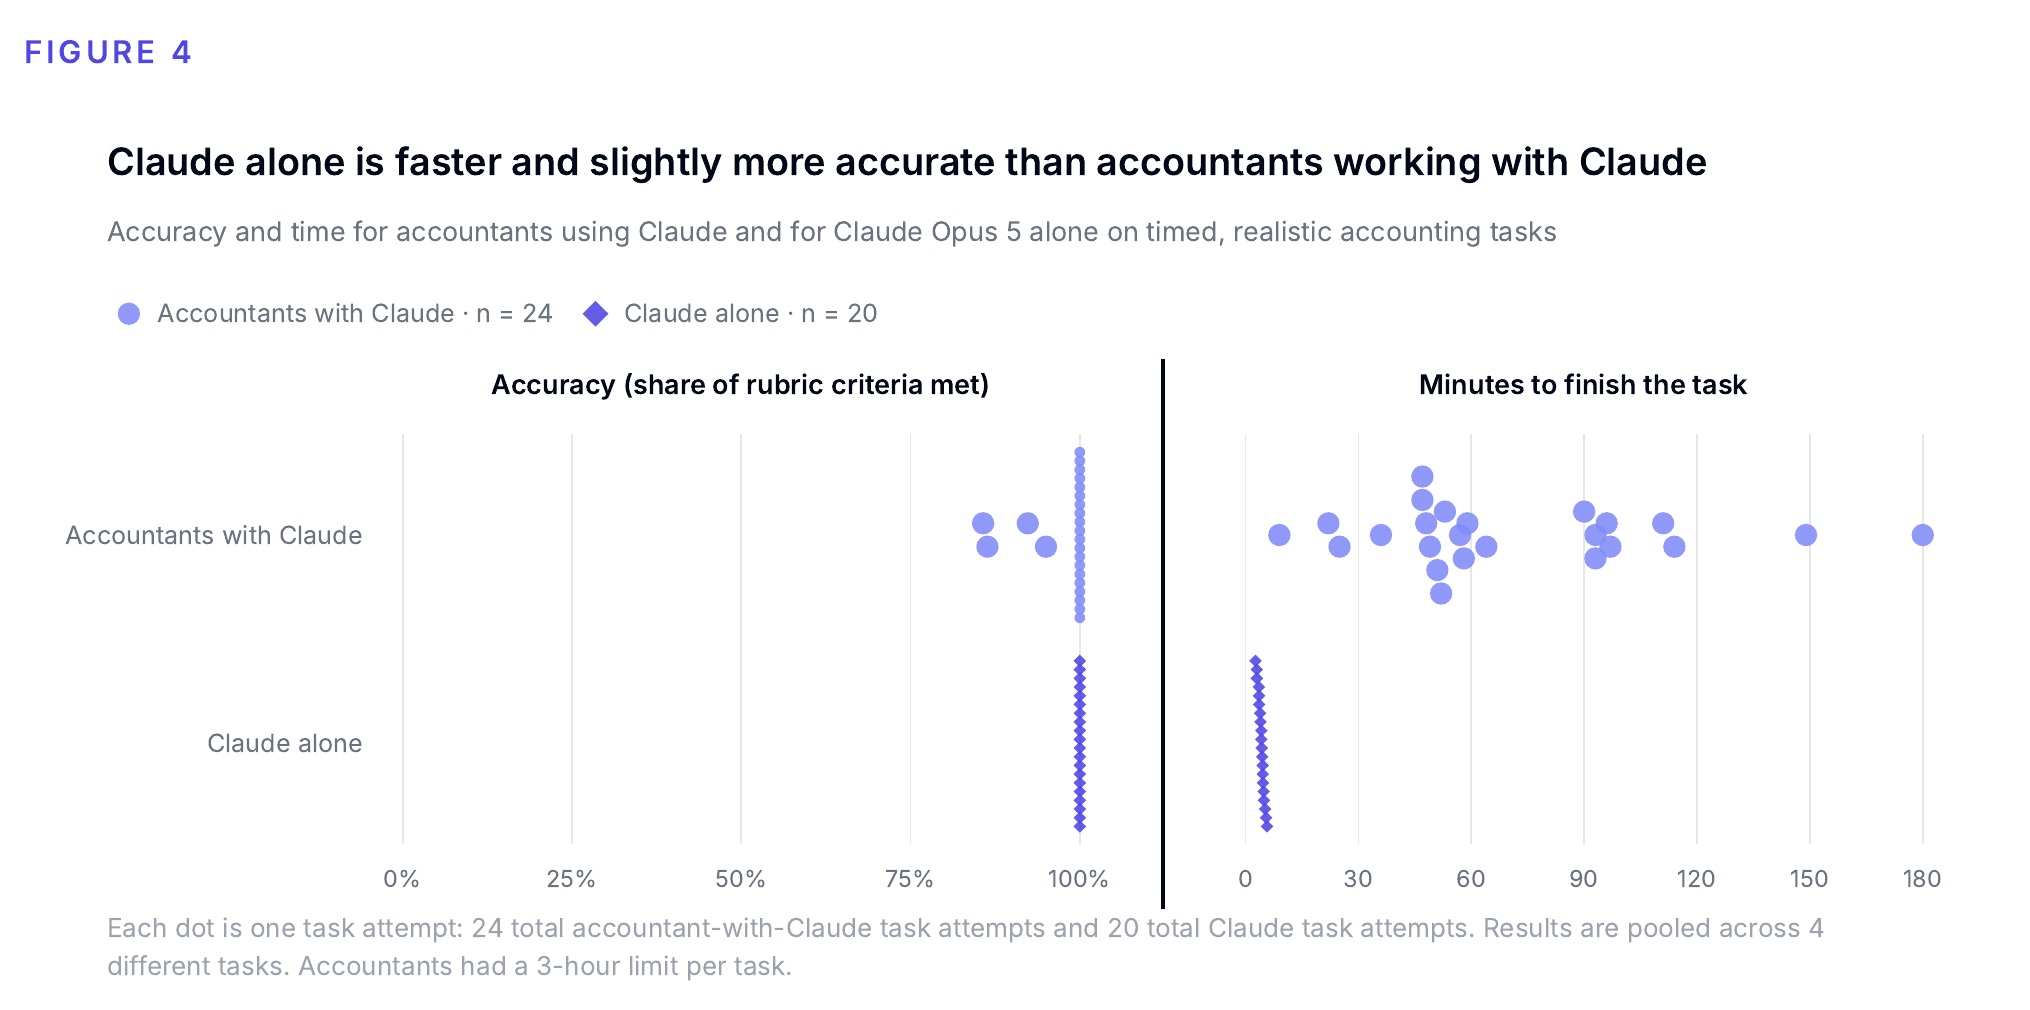
그런데 사람과 Claude의 협업 결과는 Claude 혼자 푼 것보다 느렸고 정확도도 조금 낮았습니다. 과제당 걸린 시간은 Claude 단독의 약 15배였습니다. 만점을 받지 못한 협업 사례 네 건 가운데 세 건에서 Claude는 과정 중 맞는 수치를 제시했지만 최종 답에 반영되지 않았습니다. 두 사례에서는 Claude가 맞는 숫자를 다른 값으로 다시 고치자 회계사가 바뀐 값을 그대로 따랐고, 한 사례에서는 회계사가 Claude의 맞는 조언을 뒤집었습니다. AI가 이미 만점을 받는 과제에서는 사람이 결과를 검토하는 시간이 더해졌습니다.
채점 항목당 비용은 49분의 1
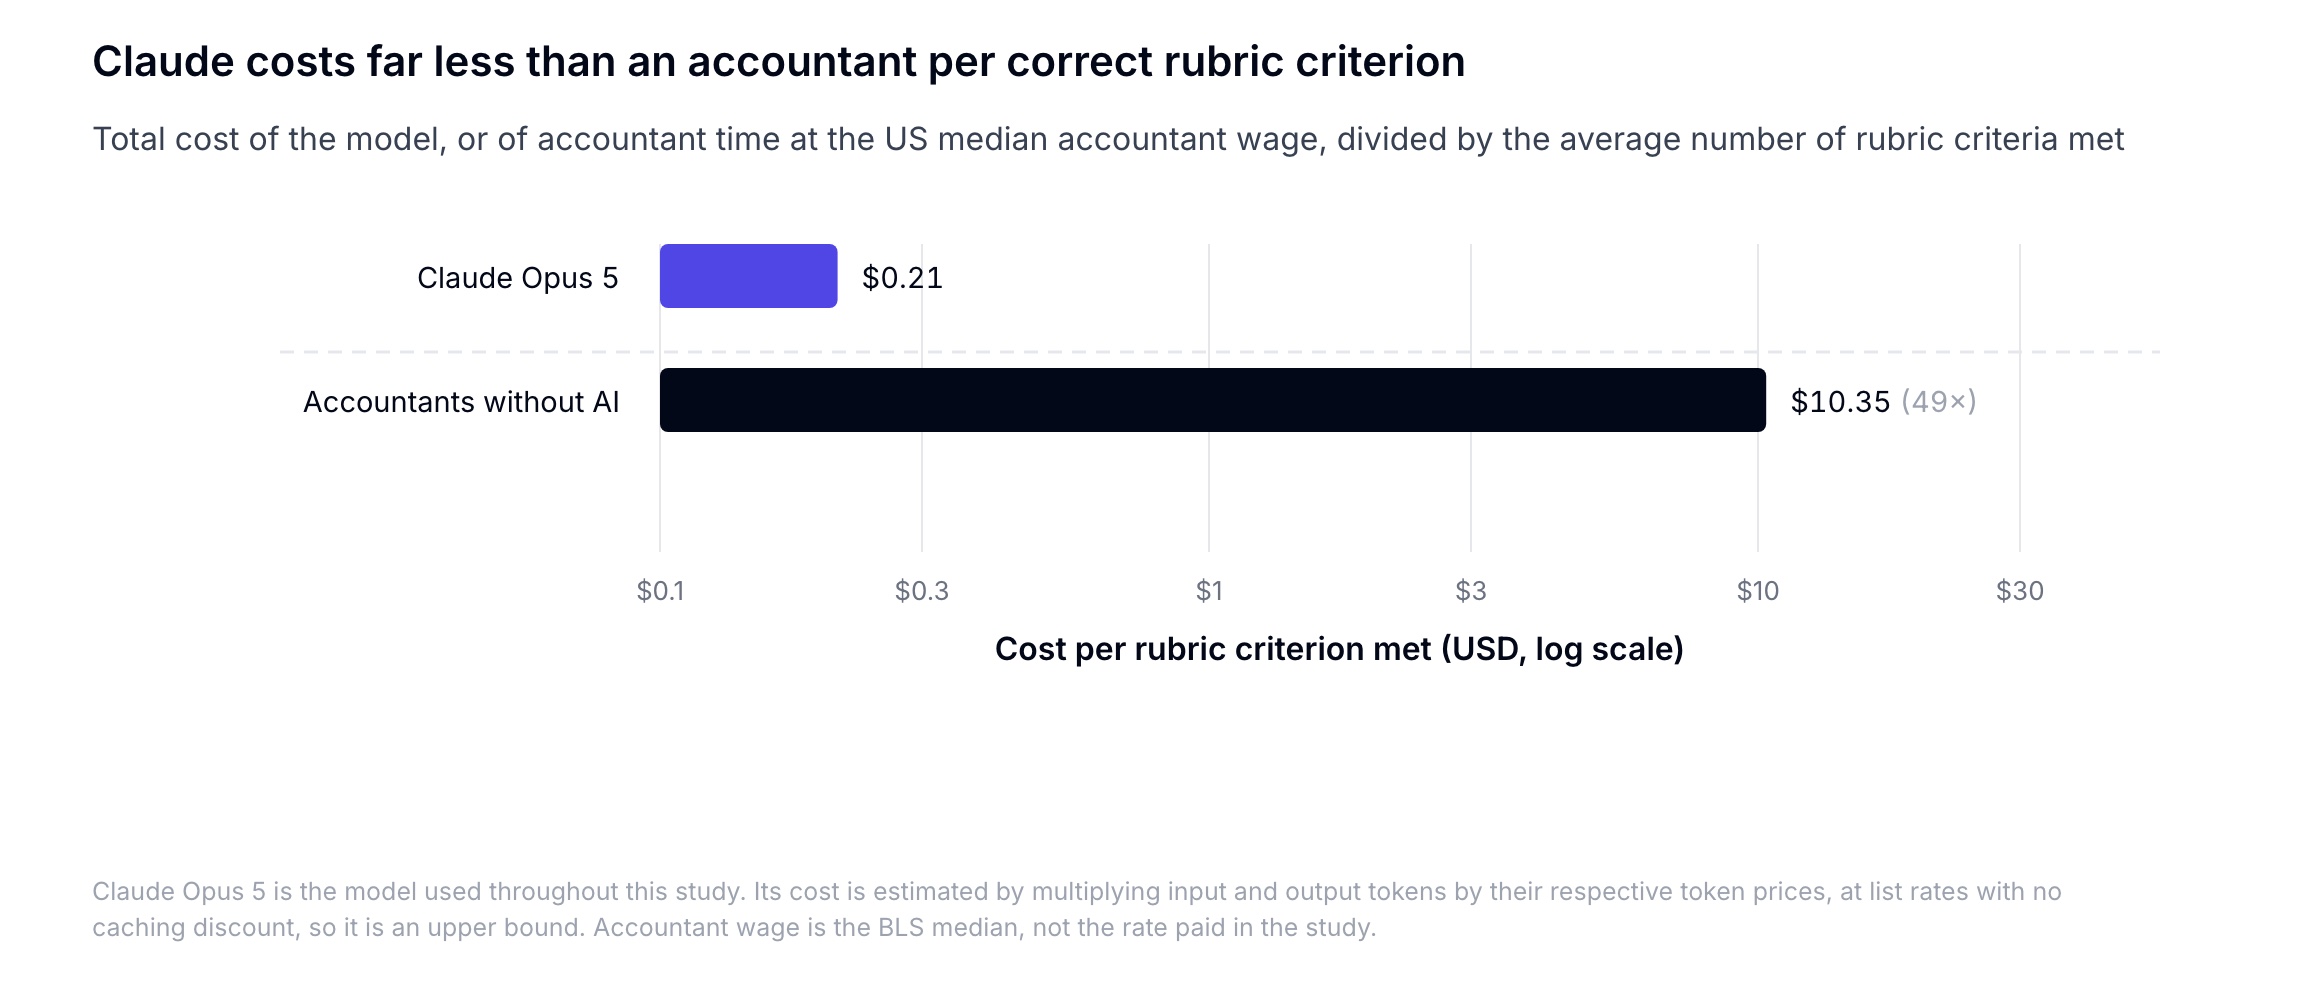
채점 항목 하나를 맞히는 비용은 Claude Opus 5가 0.21달러, 회계사는 10.35달러였습니다. 미국 회계사 임금 중간값을 적용하면 사람 쪽 비용이 약 49배 높습니다. Claude 비용은 캐시 할인 없는 API 정가로 계산한 값이며, 회계사는 실험 참가비가 아니라 미국 노동통계국의 임금 중간값을 기준으로 했습니다.
회계사 평균 정답률이 60%를 넘는 채점 항목만 보면 AI는 34배 빠르게 처리했습니다. 모델 성능이 지금 수준에서 더 발전하지 않더라도, 머코어는 회계 업무 생산성이 크게 오를 수 있다고 봤습니다.
정답은 처음 받은 파일 안에 있었습니다
머코어는 과제를 만든 회계사들과 공정성을 다시 점검했습니다. 답을 찾는 데 필요한 정보는 처음 받은 파일에 모두 있었습니다. 다만 과제는 원래 AI가 틀리도록 다듬어져 있었습니다.
호텔 과제에서는 12월 말 투숙분 일부가 다음 달인 1월 3일에 청구돼 12월 매출에서 빠져 있었습니다. 다른 회사 소개에는 매달 리스 재분류를 한다고 적혀 있었지만, AI 없이 푼 참가자 대부분은 이 작업을 건너뛰었습니다. 한 항목을 놓치면 뒤 계산이 연이어 틀릴 수 있었고 참가자는 동료나 고객에게 물어볼 수 없었습니다.
참가자 12명 중 7명은 과제가 현실적인 업무와 비슷하다고 답했습니다. 비현실적이라고 본 참가자들도 주로 동료가 없는 환경을 문제로 꼽았습니다.
APEX-Accounting 원본에서는 AI도 과제를 놓쳤습니다
머코어는 램프(Ramp)와 함께 7월 31일(한국 시간 8월 1일) APEX-Accounting을 공개했습니다. 가상 회사 10곳의 결산 과제 160개에서 당시 1위였던 Claude Fable 5도 채점 항목의 56.4%만 맞혔습니다. 가장 꾸준한 모델도 전체 시도에서 여덟 번 모두 완벽하게 푼 과제는 2.6%였고, 과제의 58%는 어떤 모델도 한 번도 완전히 풀지 못했습니다.
이번 사람 대 AI 실험은 원본 과제를 3시간 안에 풀 수 있는 크기로 줄이고 파일 안내서를 붙였습니다. 원본에서 가장 흔한 실수는 앞 단계에서 찾은 불일치를 최종 계산이나 분개에 반영하지 못하는 것이었습니다. 회계사와 Claude가 함께 풀면서 맞는 숫자를 놓친 사례와 같은 유형입니다. APEX-Accounting 소개에서 원본 벤치마크를 볼 수 있습니다.
벤치마크는 AI만 풀 수 있는 과제로 이동합니다
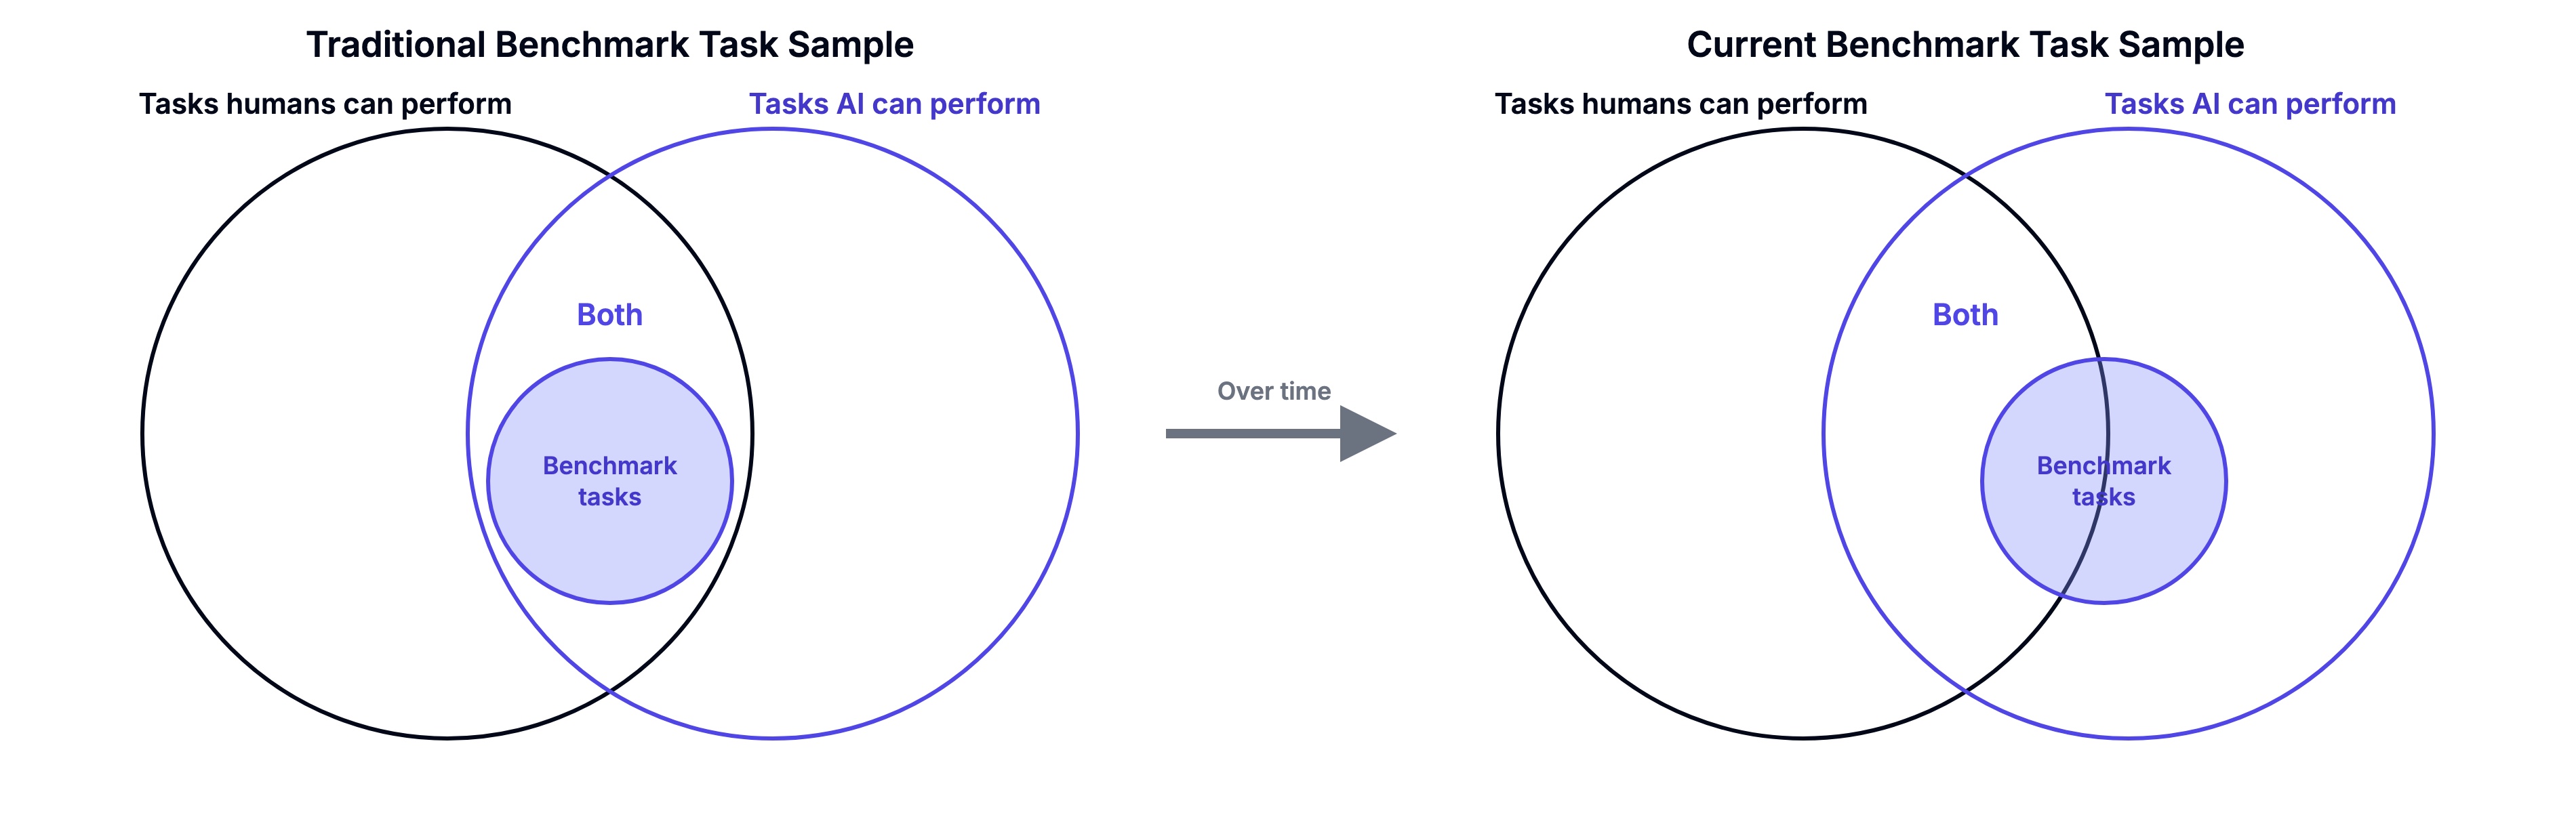
AI 모델이 틀리도록 벤치마크 과제가 계속 어려워지면, 사람 한 명이 혼자 풀기 어려운 과제도 늘어납니다. 과제는 사람과 AI 모두 할 수 있는 영역에서 AI만 해낼 수 있는 영역으로 이동합니다.
사람이 시속 60마일(약 97km)로 달리지 못해도 자동차는 그 속도로 사람을 옮겨 생산성을 높입니다. AI만 할 수 있는 일이 만들어 내는 생산성도 경제적으로 큰 가치가 될 수 있습니다. 다만 그런 일은 아직 경제 안에서 거의 이뤄지지 않아 임금 통계로 가치를 재기 어렵습니다. 머코어는 벤치마크를 공개할 때 사람도 할 수 있는 과제와 AI만 할 수 있는 과제의 비율을 함께 측정하자고 제안했습니다.
변화는 주니어 회계사에게 먼저 닿습니다
벤치마크 점수는 빠르게 올랐지만 미국 생산성 통계에는 AI의 효과가 거의 보이지 않는다는 것이 머코어의 문제 제기입니다. 이번 실험에서 AI는 파일을 빠짐없이 살피고 지시를 따르는 결산 작업에서 회계사보다 빠르고 정확했으며 비용도 49분의 1이었습니다.
실험은 고객과 대화하거나 필요한 질문을 찾는 일, 규칙이 분명하지 않은 상황에서 판단하는 능력은 측정하지 않았습니다. 머코어는 회계사의 일이 점차 이런 업무로 이동할 것으로 봤습니다. 반복 업무를 AI에 맡기는 사례로는 Claude Cowork와 ChatGPT로 업무를 자동화하는 방법도 있습니다.
이 변화는 주니어 회계사에게 가장 먼저 닿습니다. 이번에 AI가 앞선 월말 결산이 주니어 회계사가 매달 직접 처리하는 업무이기 때문입니다.