긴 PDF에서 답이 있는 페이지를 찾을 때 모든 페이지를 한 번에 비교하면 입력 길이와 선택지 수가 빠르게 커집니다. VectifyAI의 오픈소스 jev-doc-search는 PageIndex가 만든 문서 트리를 따라 Jev Choice로 관련 섹션과 페이지를 차례로 좁힙니다. 임베딩이나 벡터 데이터베이스 대신 문서의 계층 구조와 각 노드의 요약을 검색에 활용합니다.
출처: X @PageIndexAI
평면 페이지 검색은 문서가 길어질수록 한계에 닿습니다
저장소에는 PDF의 페이지 텍스트를 뽑아 한 번의 Jev Choice 요청에 넣는 page_search.py가 있습니다. 질문은 판단의 상태로, 페이지별 텍스트는 선택지 설명으로 전달합니다. Jev는 후보 중 가장 가능성 높은 페이지를 고르고 선택지별 확률도 반환합니다.
이 방식은 한 요청의 컨텍스트가 32k 토큰 이내여야 하고 Choice 하나에는 최대 255개 선택지만 넣을 수 있습니다. 코드도 여유를 두고 상태를 30,000 토큰 이하로 검사합니다. README가 든 NVIDIA FY2026 10-K는 93페이지이며 약 76k 토큰이라 컨텍스트 한도를 넘습니다. Citigroup FY2025 10-K는 318페이지라 한 Choice의 선택지 수를 넘습니다. 문서가 길수록 페이지 전체를 한 요청으로 비교하는 방법 대신 검색 범위를 나눌 구조가 필요합니다.
PageIndex 트리에서 답이 있을 구역을 선택합니다
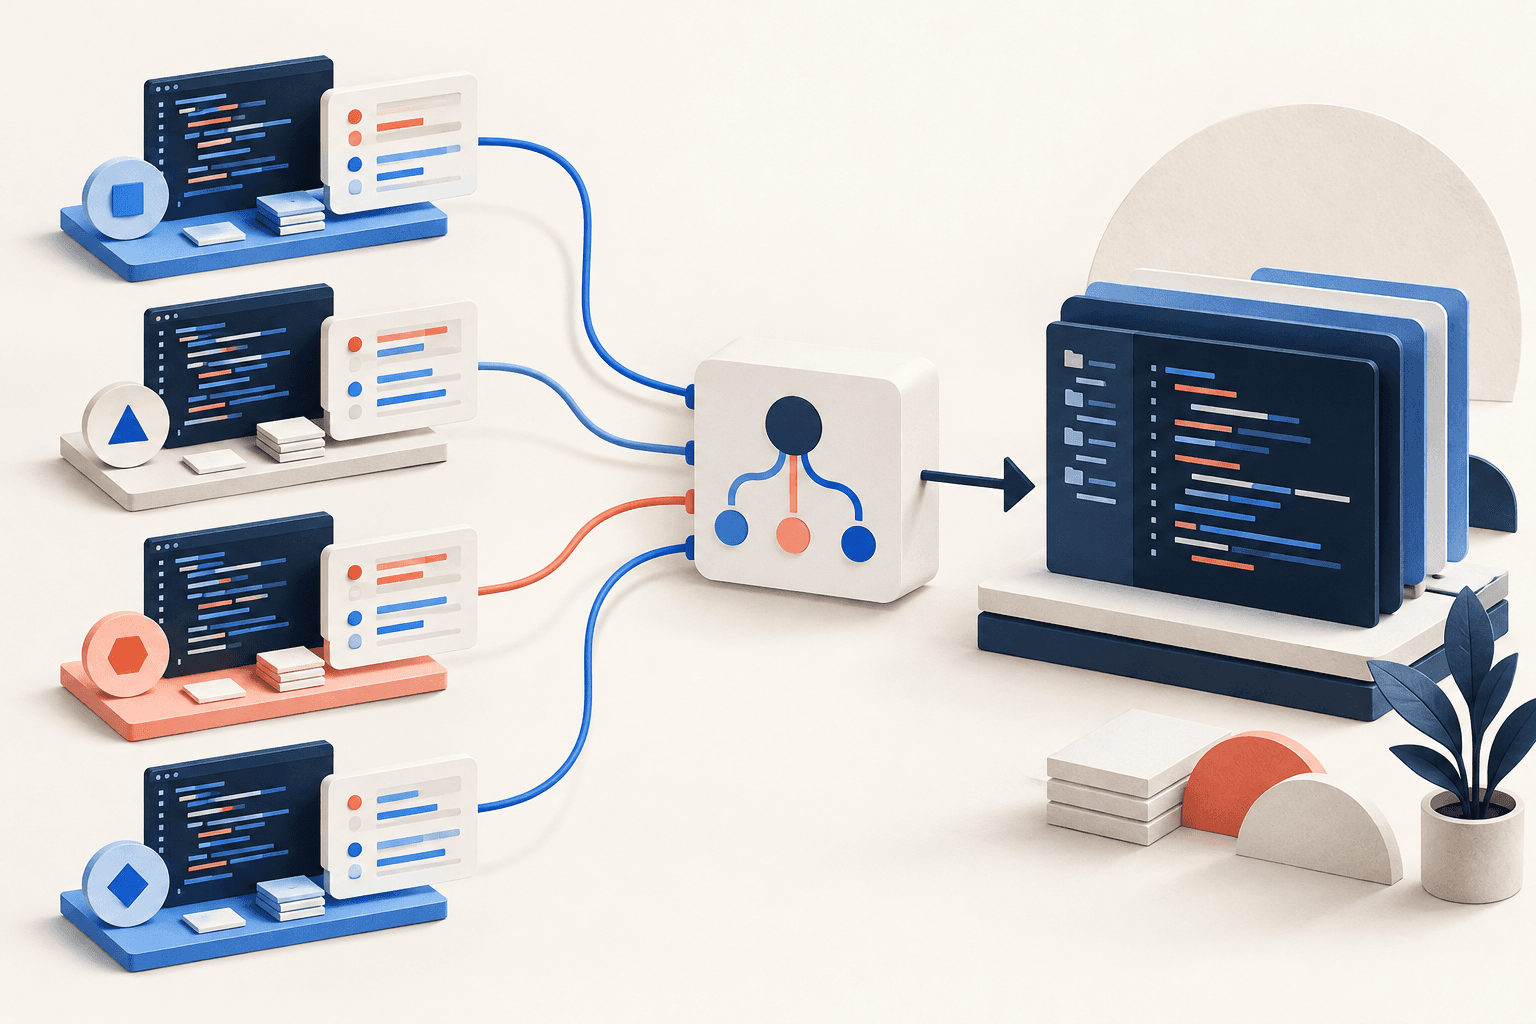
PageIndex는 문서를 루트로 두고, 그 아래에 제목·요약·페이지 범위를 가진 섹션과 하위 섹션을 놓은 트리를 만듭니다. 말단에는 실제 페이지 콘텐츠가 있습니다. tree_search.py는 트리의 각 단계에서 자식 노드의 제목과 요약을 Choice 선택지로 만들어 질문에 관련된 경로를 고릅니다. 하위 섹션이 있으면 그 아래로 내려가고, 말단에 도달하면 해당 페이지 텍스트를 비교합니다.
간단한 README 예제는 가장 높은 확률의 선택지를 따라 한 단계씩 내려갑니다. 전체 구현은 한 경로만 택했을 때 정답 섹션을 놓칠 수 있어 top-K 탐색을 더합니다. 각 섹션 단계에서 점수가 높은 경로 3개를 유지하는 beam search입니다. 섹션의 하위 절보다 앞에 놓인 페이지도 선택지에 포함하고, 페이지가 한 요청에 다 들어가지 않으면 요청 크기에 맞는 구간으로 나눕니다.
그다음 후보 페이지를 최대 16개까지 Jev Noul로 확인합니다. Noul은 각 페이지에 대해 “이 페이지에 질문의 답이 있습니까?”라는 yes/no 판단을 독립적으로 수행합니다. 확률이 0.5 이상인 페이지를 남기며, 기준을 통과한 페이지가 없으면 상위 두 페이지를 결과로 돌려줍니다. README의 간단한 트리 예제와 전체 tree_search.py의 top-K·Noul 단계는 구분해서 볼 수 있습니다.
설치하고 첫 문서를 검색하는 방법
Python 환경에서 저장소를 복제하고 의존성을 설치합니다. Jev 요청에 필요한 TypeSafe 키와 PDF 트리 생성에 필요한 PageIndex 키를 환경 변수로 지정합니다.
git clone https://github.com/VectifyAI/jev-doc-search.git
cd jev-doc-search
pip install -r requirements.txt
export TYPESAFE_API_KEY="발급받은_키"
export PAGEINDEX_API_KEY="발급받은_키"
README의 requirements에는 pageindex>=0.2.21, typesafe-sdk==0.7.2, tiktoken, pypdf가 포함됩니다. 예를 들어 NVIDIA 보고서에서 2026 회계연도 총매출을 찾으려면 PDF와 질문을 함께 전달합니다.
python tree_search.py NVIDIA_10K.pdf "What was NVIDIA's total revenue for fiscal year 2026?"처음 실행하면 PDF를 PageIndex에 제출해 트리를 만들고 doc_id를 출력합니다. 결과에는 탐색한 섹션 경로와 찾은 페이지가 표시됩니다. 같은 문서에 다른 질문을 할 때 PDF를 다시 올리지 않고 앞서 받은 doc_id를 첫 번째 인수로 사용합니다.
python tree_search.py pi-... "What was NVIDIA's gross margin for fiscal year 2026?"page_search.py는 페이지 전체를 Choice로 비교하는 간단한 기준선이고, 긴 문서에서 트리 경로·페이지 후보·Noul 확인을 함께 쓰려면 tree_search.py를 실행합니다. 저장소가 사용하는 PageIndex API는 문서를 제출하고 완료된 트리를 조회하는 흐름을 제공하며, Jev의 Choice와 Noul은 각각 선택지 탐색과 후보 페이지 확인을 맡습니다.
10-K 예시에서 찾은 페이지
저장소 README는 PageIndex에 올린 연차보고서 두 건으로 검색 결과를 기록했습니다. NVIDIA FY2026 10-K는 93페이지·약 76k 토큰이며 총매출 질문에서 p37과 p51을 반환했습니다. 연결 손익계산서는 p51에 있습니다. Citigroup FY2025 10-K는 318페이지이며 순이익 질문에서 p12, p16, p134, p135를 반환했고 연결 손익계산서는 p134라고 설명합니다.
이 예시에서 검색은 문서 전체를 한 번에 페이지 선택지로 만드는 대신 섹션 트리에서 후보 범위를 줄인 다음 실제 페이지 내용을 비교합니다. Jev 기반 코드 검색 도구 jevgrep도 자연어 질문에서 관련 파일과 코드 구역을 단계적으로 찾습니다. Jev 모델 자체의 구조와 사용 사례는 CLM-8B와 Jev 소개에서 이어서 볼 수 있습니다.