사진 한 장은 한 방향의 장면만 보여 줍니다. 카메라가 옆으로 움직여 원래 프레임에 없던 곳을 비추면 장면은 어떻게 이어질까요? InSpatio-World 1.5는 이미지나 영상에서 출발해 새로운 시점의 장면을 생성하는 오픈소스 월드 모델입니다. 공식 프로젝트 페이지는 단일 이미지, 이미지 묶음, 파노라마, 영상으로 장면을 탐색하는 예시를 소개합니다.
이미지에서 시작해 카메라 시점을 바꿉니다
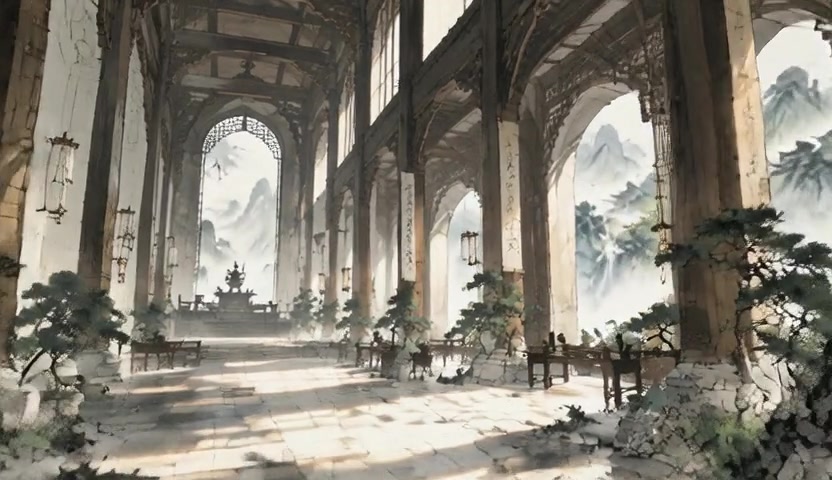
단일 이미지 예시에서는 카메라를 원래 시야 바깥으로 이동해 가려져 있던 공간을 생성합니다. 프로젝트는 큰 시점 변화에도 장면의 스타일과 공간 구조를 이어가는 것을 목표로 설명합니다. 공식 페이지에는 복도와 성, 다리, 구름 궁전 장면이 올라와 있습니다.
여러 이미지를 이용하는 예시는 네 장의 입력에서 피사체 주변을 도는 불릿타임 카메라 경로를 만듭니다. 파노라마 입력 예시도 공식 페이지에 포함되어 있어 넓은 시야에서 장면을 탐색하는 모습을 볼 수 있습니다. 다만 GitHub README가 안내하는 로컬 추론 입력은 단일 이미지, 네 장 이미지, 영상입니다. 파노라마는 공식 소개 페이지의 데모 기능으로 확인되며 README의 로컬 입력 목록에는 따로 적혀 있지 않습니다.
영상에서는 시간의 흐름 속 다음 시점을 예측합니다
영상 입력은 움직임이 이어지는 동안 관찰 시점을 바꾸어 새 시점의 장면을 생성하는 데 쓰입니다. 프로젝트는 이를 동적 세계의 다음 시점 예측으로 소개합니다. 굴러가는 오렌지, 숲속 보트 이동, 비 오는 밤의 오두막 등 시간에 따라 장면이 변하는 데모를 공식 페이지에서 볼 수 있습니다.
공개된 1.5 코드로 사용자 영상을 실행할 때는 입력 영상과 프롬프트 외에 프레임마다 타깃 카메라 궤적을 지정해야 합니다. 따라서 원본 영상만 넣으면 임의의 카메라 이동을 자동으로 정해 주는 방식은 아닙니다.
코드와 체크포인트, 로컬 실행 조건
InSpatio-World 1.5 공식 프로젝트 페이지는 입력별 데모와 라이브 데모를 제공합니다. 추론 코드와 설치 방법은 GitHub 저장소에, 체크포인트는 Hugging Face 저장소에 공개되어 있습니다. GitHub README는 기본 1.5 체크포인트를 1.3B로 표기합니다. Hugging Face 저장소에는 모델 카드가 없고 Inference Provider 배포도 제공되지 않습니다.
로컬 환경에는 Python 3.10과 CUDA 12.6이 필요합니다. 기본 체크포인트와 함께 Wan2.1-T2V-1.3B 구성요소 및 Depth Anything 3도 준비해야 합니다. 저장소 예제는 Conda 환경을 만든 뒤 Depth Anything 3를 설치하고, 저장소의 bash run_example.sh로 제공 장면을 실행하는 흐름입니다. Hopper GPU에서는 FlashAttention-3 설치를 권장합니다.
저장소의 Apache-2.0 라이선스는 공개 코드에 적용됩니다. Depth Anything 3를 비롯한 의존성은 각기 다른 라이선스를 따르므로 코드와 모든 구성 요소를 하나의 라이선스로 묶어 설명할 수 없습니다.
참고할 만한 인접 사례로 Tencent WorldCrafter 비디오 월드 모델도 있습니다. 두 프로젝트 모두 새 시점의 장면 생성을 다루지만 서로 다른 모델과 기술 접근을 사용합니다. InSpatio-World 1.5는 이미지 입력을 네 장 묶음과 파노라마까지 확장해 소개하고, 영상 탐색도 지원하는 점이 특징입니다.
성능 수치는 버전을 나눠 읽어야 합니다. 1.5 GitHub가 기본 체크포인트를 1.3B로 표기하는 것과, InSpatio-World 1.0 논문이 보고한 성능 결과는 별개의 정보입니다. WorldScore-Dynamic 68.72점, 논문 비교표의 실시간·인터랙티브 방법 중 1위, 최대 24 FPS는 1.0 결과이며 1.5의 성능 측정치가 아닙니다.
영상 AI를 다룬 다른 사례로는 생성 모델과 용도가 다른 Gemini API 에이전트형 영상 분석이 있습니다. 소스 코드를 바탕으로 설명 영상을 만드는 anything2explainer도 AI 영상 제작의 인접 사례입니다.