컴퓨터 화면을 보고 버튼을 누르거나 양식을 채우는 AI를 작은 모델로 직접 돌려 볼 수 있게 됐다. Cua가 2026년 9월 24일(한국 시간) 공개한 Cua-S1-4B-0.2는 화면과 목표, 가능한 행동 후보를 받아 다음 행동 하나를 고르는 4B 컴퓨터 사용 모델이다. GUI-360의 고정된 멀티모달 평가 168개 작업에서 92.9%를 기록했고, 어댑터와 학습·평가 코드를 공개했다.
출처: X @trycua. 공식 발표는 모델을 “the first multimodal decision model trained with RLOO on live computer-use tasks, using task-completion rewards”라고 소개했다. 실제 컴퓨터 사용 작업에서 완료 여부를 보상으로 삼아 RLOO로 학습한 첫 멀티모달 결정 모델이라는 뜻이다.
작은 모델이 한 번에 하나의 행동을 고른다
Cua-S1-4B-0.2의 베이스는 Qwen/Qwen3.5-4B다. 전체 베이스 모델 위에 LoRA 어댑터를 얹어 컴퓨터 조작에 맞췄다. 모델 카드에는 두 어댑터가 공개돼 있다. text 어댑터는 화면 요소의 텍스트와 접근성 정보를 읽고, multimodal 어댑터는 스크린샷을 입력으로 받는다.
발표 영상의 문구는 “Small model. One decision at a time.”과 “Every step is one decision.”이다. 전체 작업 계획을 한 번에 문장으로 생성하는 대신, 현재 화면에서 고를 수 있는 행동마다 점수를 내고 가장 적절한 후보 하나를 고른다.
화면·목표·후보 행동을 받아 다음 한 걸음을 결정
입력은 현재 화면 상태, 사용자가 이루려는 목표, 그리고 실행기가 준비한 후보 행동 목록이다. 후보 하나는 화면 요소와 행동의 조합으로 표현할 수 있다.
(Edit "Email", fill): 이메일 입력란에 값 채우기(Button "Submit", click): 제출 버튼 누르기(Checkbox "Agree", check): 동의 체크박스 선택(Dropdown "Country", select): 목록에서 항목 고르기
지원 행동은 fill, check, click, select, scroll, skip 등이다. 실행기는 모델이 고른 행동을 수행한 뒤 바뀐 화면을 다시 읽고, 다음 후보 목록과 함께 모델에 전달한다. 이 반복 루프로 로그인, 검색, 양식 작성, 제출처럼 여러 단계로 이어지는 작업을 처리한다.
작업 완료를 보상으로 쓰는 두 단계 훈련
첫 단계는 지도 미세조정(SFT)이다. 화면 상태와 후보 행동, 올바른 선택을 짝지어 모델이 행동 선택 형식에 익숙해지도록 학습한다.
두 번째 단계는 실제 Cua GUI 환경에서 진행하는 RLOO 강화학습이다. 모델이 같은 작업을 여러 번 시도하고, 목표를 끝까지 완료했는지를 보상으로 받는다. 한 작업에서 나온 여러 시도의 보상을 서로 비교해 결과가 좋은 선택을 더 강화하는 방식이다. 훈련 코드는 Cua 저장소의 libs/cua-s1에 공개됐다.
GUI-360 평가에서 멀티모달 92.9%
GUI-360은 Windows 오피스 앱을 중심으로 화면, 목표, 접근성 정보와 행동 궤적을 모은 컴퓨터 사용 데이터셋·벤치마크다. 전체 데이터는 여러 과제를 포함하며, Cua 저장소는 그중 고정한 멀티모달 테스트 분할의 168개 작업으로 모델을 평가했다. 이 비교에서는 접근성 트리 대신 화면 이미지 입력을 사용했다.
| 모델 | 168개 작업 정확도 |
|---|---|
| Cua-S1-4B-0.2 (multimodal) | 92.9% |
| djev (zero-shot 기준선) | 60.1% |
| semif (zero-shot 기준선) | 24.4% |
djev는 표의 미훈련 zero-shot 기준 모델 이름이다. 벤치마크를 구성한 작업 유형별 결과를 보면 폼 입력, 로그인, 검색·필터, 페이지 넘기기에서 Cua-S1-4B-0.2가 높은 정확도를 기록했다.
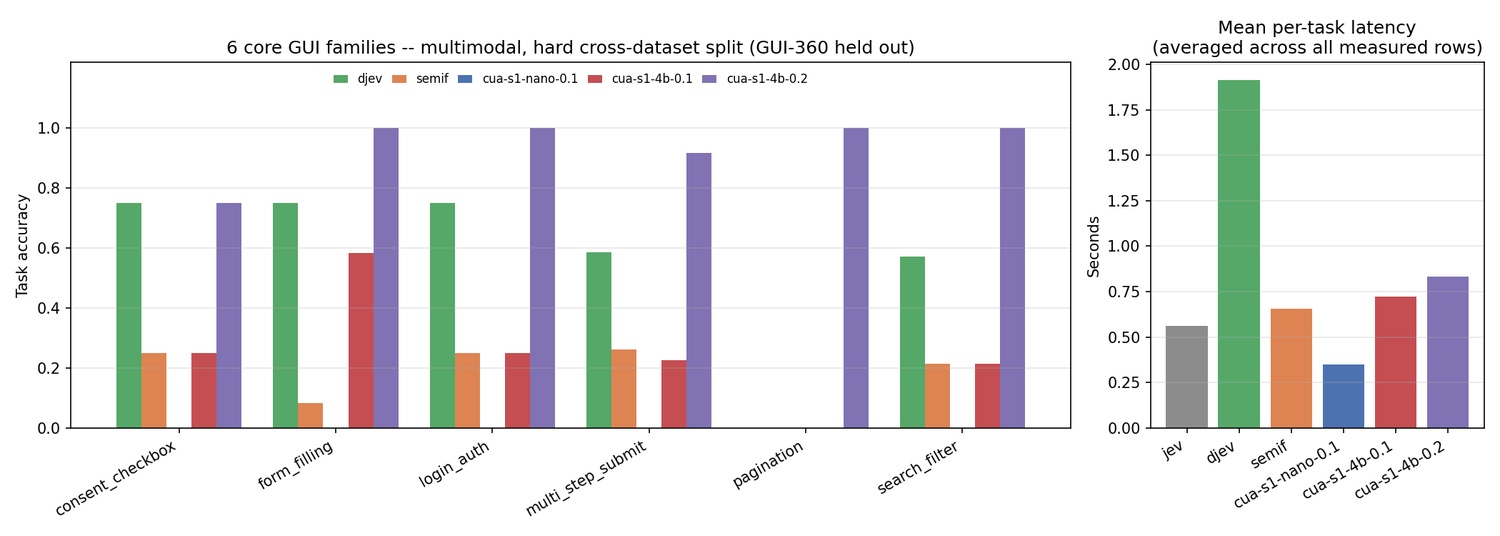
| 작업 유형 | Cua-S1-4B-0.2 | djev |
|---|---|---|
| 양식 입력 | 100% | 75% |
| 로그인 | 100% | 75% |
| 검색·필터 | 100% | 57.1% |
| 다단계 제출 | 91.7% | 58.6% |
| 동의 체크박스 | 75% | 75% |
| 페이지 넘기기 | 100% | 0% |
92.9%는 이 정해진 후보 선택 평가 분할에서의 정확도다. GUI-360 논문은 데이터셋과 평가 설정을 설명하고, Cua 저장소는 사용한 168개 멀티모달 태스크와 모델별 점수를 공개한다.
브라우저 데모에서 후보 점수를 확인
Cua는 Hugging Face Spaces에 브라우저 데모를 공개했다. 예시 작업을 고르면 화면 요소와 행동 후보별 점수를 확인할 수 있다.
공식 계정에는 녹화된 모바일·데스크톱 작업의 단계별 선택을 보여 주는 비교 시연도 올라왔다.
어댑터와 코드를 직접 실행하는 방법
Cua-S1 텍스트·멀티모달 LoRA 어댑터는 Apache-2.0으로 공개됐다. Cua 저장소의 주요 컴포넌트 libs/cua-s1에는 모델·훈련 코드가, libs/cua-bench-s1에는 평가 태스크와 결과가 들어 있다. GitHub 저장소 전체는 MIT 라이선스이며, Qwen 베이스 모델 가중치에는 Qwen의 라이선스 조건이 적용된다.
저장소 Python 프로젝트의 FourB 실행 의존성을 설치하려면:
uv sync --project libs/cua-s1/python --extra four-b모델 카드의 로딩 예시는 다음과 같다.
from cua_s1.four_b import FourBModel

model = FourBModel(
    base_model="Qwen/Qwen3.5-4B",
    lora_adapter_path="cua-ai/cua-s1-4b-0.2",
    modality="text",  # 또는 "multimodal"
)
텍스트 화면 상태에는 modality="text", 스크린샷 입력에는 modality="multimodal"을 선택한다. FourBModel이 후보 행동 점수를 계산하고, Cua 실행 환경이 후보 목록과 실제 컴퓨터 조작 루프를 연결한다. 저장소는 Transformers 5와 torchvision을 사용하는 FourB 추론 환경을 안내한다.
작은 모델로 컴퓨터 사용 AI의 한 걸음을 실험
Cua-S1-4B-0.2는 화면을 읽고 다음 행동 하나를 선택하는 컴퓨터 사용 모델을 4B 규모로 공개했다. 화면 요소 텍스트를 읽는 어댑터와 스크린샷을 처리하는 어댑터, 실제 작업 완료를 보상으로 주는 훈련 코드, GUI-360 평가 코드를 함께 살펴볼 수 있다. 거대한 모델 하나에 모든 결정을 맡기던 흐름에, 가벼운 모델이 단계마다 선택하는 구조를 직접 실행해 볼 수 있는 선택지가 더해졌다.