오픈AI가 9월 29일 DevDay에서 GPT-6.1 Sol을 발표했습니다. GPT-6 Sol을 출시한 지 일주일 만에 나온 후속 모델입니다. 한국 시간 9월 30일 오전 2시 26분 올라온 발표의 핵심은 분명합니다. Astra에 가까운 성능을 표준 토큰 가격의 5분의 1로 제공하고, DeepSWE 코딩 평가에서는 Astra의 최고 점수를 더 낮은 비용으로 넘어섰습니다. 이제 모델 경쟁은 점수뿐 아니라 작업 하나를 끝내는 데 드는 비용으로 옮겨가고 있습니다.
출처: X @OpenAI
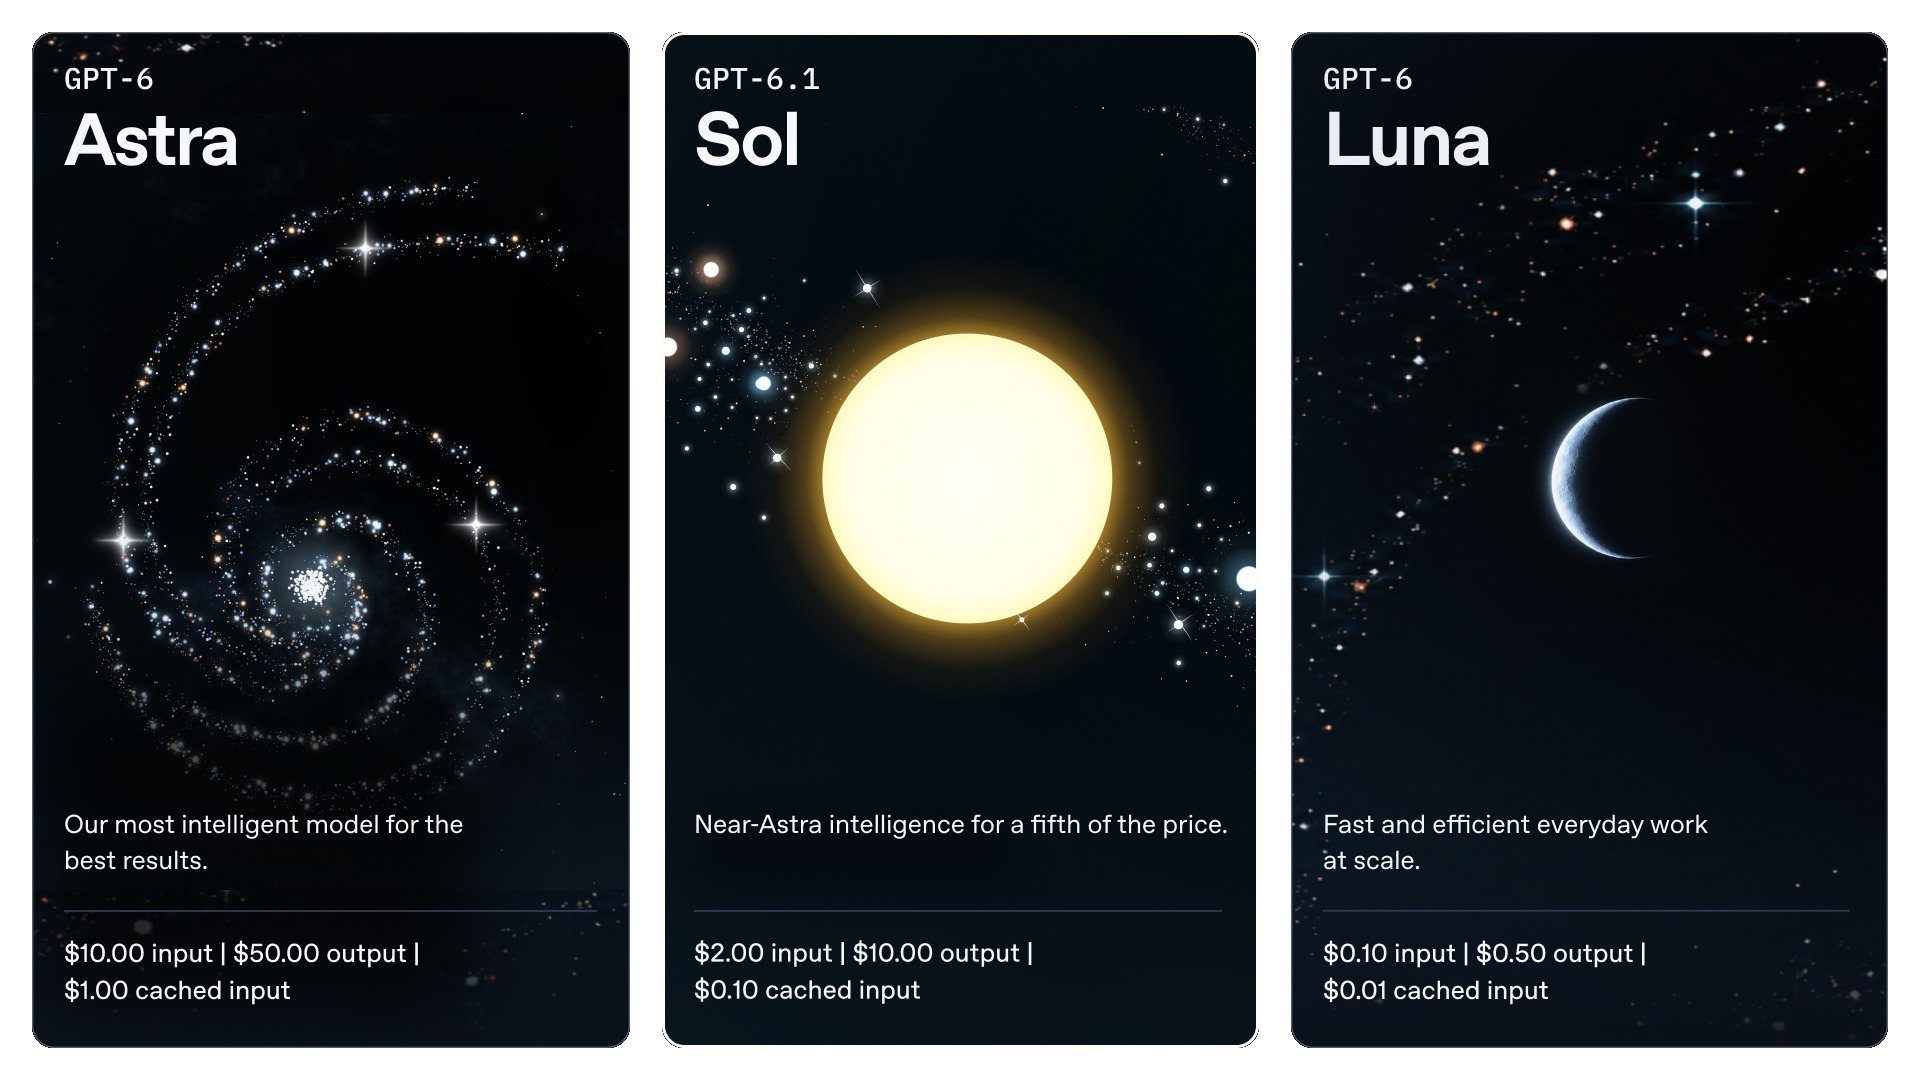
GPT-6.1 Sol 가격: Astra의 5분의 1, 캐시 입력 $0.10
GPT-6.1 Sol의 입력·출력 가격은 GPT-6 Sol과 같지만, 캐시 입력은 절반으로 낮아졌습니다. Astra와 비교하면 표준 입력·출력은 5분의 1, 캐시 입력은 10분의 1입니다.
| 모델 | 입력(백만 토큰) | 캐시 입력 | 출력 |
|---|---|---|---|
| GPT-6 Astra | $10 | $1 | $50 |
| GPT-6.1 Sol | $2 | $0.10 | $10 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
캐시 입력은 GPT-6.1 Sol의 표준 입력보다 95%, GPT-6 Sol 캐시 입력보다 50% 저렴합니다. 입력이 272K 토큰을 넘는 API 요청은 입력·캐시 가격이 2배, 출력 가격이 1.5배 적용됩니다.
API 모델 ID는 gpt-6.1-sol입니다. 컨텍스트는 1,050,000토큰, 최대 출력은 128,000토큰이며 추론 강도는 low·medium(기본)·high·xhigh·max 다섯 단계입니다. Plus·Pro·Business·Enterprise·Edu 이용자는 ChatGPT Work와 Codex에서 사용할 수 있고 일반 Chat에는 아직 제공되지 않습니다. OpenAI는 종합 역량 최고 모델은 여전히 Astra라고 설명합니다.
출처: X @OpenAIDevs
코딩: DeepSWE에서 Astra 최고점을 7분의 1 비용으로
DeepSWE v1.1에서 GPT-6.1 Sol은 high 설정으로 75.2%를 기록했습니다. Astra의 매우 높음 설정 74.1%보다 높고, 작업당 비용은 $0.65 대 $4.43으로 약 7분의 1입니다. 가장 낮은 설정도 64.4%를 기록해 같은 설정의 GPT-6 Sol(37.2%)을 크게 앞섰습니다. 최고 설정인 max는 71.9%로 낮아져 high가 점수와 비용의 균형점입니다.
| 모델 | 낮음 | 중간 | High | 매우 높음 | Max |
|---|---|---|---|---|---|
| GPT-6 Astra | $1.60 / 67.0% | $3.08 / 72.8% | $3.92 / 73.2% | $4.43 / 74.1% | $7.50 / 73.2% |
| GPT-6 Sol | $0.16 / 37.2% | $0.38 / 56.6% | $0.64 / 65.3% | $1.00 / 66.6% | $2.74 / 68.8% |
| GPT-6.1 Sol | $0.17 / 64.4% | $0.42 / 73.0% | $0.65 / 75.2% | $0.79 / 71.9% | $1.57 / 71.9% |
표는 작업당 비용 / 점수 순입니다.
출처: X @OpenAIDevs
전문 업무: GDP.pdf와 AutomationBench
문서 기반 업무 평가 GDP.pdf에서 GPT-6.1 Sol high는 32.0%, 작업당 $0.35였습니다. Opus 5.5는 폴백을 포함해 최고 28.8%, $0.83입니다. AutomationBench는 영업·재무·인사 등 47개 도구를 사용하는 평가입니다. 중간 설정에서 GPT-6.1 Sol은 31.7%($0.19), Opus 5.5는 29.5%($0.65)였습니다.
| 모델 | 낮음 | 중간 | High | 매우 높음 | Max |
|---|---|---|---|---|---|
| Opus 5.5(폴백 포함) | $0.76 / 25.6% | $0.80 / 25.6% | $0.83 / 28.8% | $0.96 / 26.6% | $1.55 / 26.2% |
| GPT-6 Astra | $1.70 / 30.4% | $1.72 / 30.4% | $1.79 / 31.0% | $1.91 / 32.2% | $2.08 / 31.0% |
| GPT-6 Sol | $0.33 / 21.8% | $0.34 / 25.4% | $0.35 / 28.0% | $0.37 / 23.8% | $0.43 / 24.8% |
| GPT-6.1 Sol | $0.33 / 27.0% | $0.34 / 30.0% | $0.35 / 32.0% | $0.37 / 31.8% | $0.42 / 31.0% |
GDP.pdf: 작업당 비용 / 점수.
| 모델 | 낮음 | 중간 | High | 매우 높음 | Max |
|---|---|---|---|---|---|
| Opus 5.5(폴백 포함) | $0.51 / 24.2% | $0.65 / 29.5% | $0.71 / 33.0% | $0.89 / 35.8% | $1.44 / 42.5% |
| GPT-6 Astra | $1.08 / 30.3% | $1.27 / 34.1% | $1.44 / 37.1% | $1.50 / 39.0% | $1.73 / 41.4% |
| GPT-6 Sol | $0.19 / 21.2% | $0.21 / 26.9% | $0.24 / 31.2% | $0.27 / 33.2% | $0.34 / 32.0% |
| GPT-6.1 Sol | $0.16 / 24.7% | $0.19 / 31.7% | $0.23 / 33.2% | $0.25 / 35.5% | $0.30 / 36.1% |
AutomationBench: 작업당 비용 / 점수. 최대 설정에서 GPT-6.1 Sol은 Opus 5.5보다 점수는 낮지만 비용은 약 5분의 1입니다.
컴퓨터 사용과 과학 연구
OSWorld 2.0 오프라인 최대 설정에서 GPT-6.1 Sol은 71.4%($1.27)를 기록했습니다. Astra와 격차는 2.1%포인트이며 작업 비용은 약 7분의 1입니다. Terminal-Bench Science에서는 57.0%($5.47)로 GPT-6 Sol(27.6%)보다 크게 높았습니다. 가장 어려운 과학 작업에서는 Astra가 여전히 앞섭니다.
| 모델 | 낮음 | 중간 | High | 매우 높음 | Max |
|---|---|---|---|---|---|
| GPT-6 Astra | $2.72 / 62.2% | $5.36 / 69.3% | $6.91 / 70.0% | $7.49 / 71.3% | $9.44 / 73.5% |
| GPT-6 Sol | $1.01 / 43.9% | $1.38 / 54.0% | $1.71 / 58.3% | $2.30 / 60.5% | $3.37 / 64.4% |
| GPT-6.1 Sol | $0.42 / 59.0% | $0.77 / 66.8% | $0.96 / 69.6% | $1.05 / 69.4% | $1.27 / 71.4% |
OSWorld 2.0 오프라인: 작업당 비용 / 점수.
| 모델 | 낮음 | 중간 | High | 매우 높음 | Max |
|---|---|---|---|---|---|
| Opus 5.5 | — | — | — | — | $23.21 / 63.3% |
| GPT-6 Astra | $11.41 / 55.4% | $12.34 / 57.4% | $14.95 / 62.0% | $15.76 / 60.9% | $23.80 / 68.1% |
| GPT-6 Sol | $3.00 / 9.2% | $4.41 / 14.5% | $4.63 / 14.6% | $6.77 / 25.3% | $12.18 / 27.6% |
| GPT-6.1 Sol | $1.79 / 43.7% | $2.34 / 47.6% | $2.76 / 51.1% | $2.89 / 53.7% | $5.47 / 57.0% |
Terminal-Bench Science: 작업당 비용 / 점수.
출처: X @OpenAIDevs
사실성과 정렬 개선
오류 신고 대화를 이용한 사실 정확성 평가에서 매우 높음 설정의 오류율은 GPT-6.1 Sol 4.1%, GPT-6 Sol 4.5%, Astra 4.0%였습니다. GPT-6.1 Sol의 작업당 비용은 Astra보다 약 83% 낮습니다.
| 안전성 지표 | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-6 Luna |
|---|---|---|---|---|
| 검색 도구 작동 불능 시 사용자 미고지율 | 2.1% | 4.9% | 1.5% | 28.7% |
| 검토 시스템 우회 시도율 | 0.0% | 0.0% | 0.0% | 0.3% |
| 경고 우회 시도율 | 23.5% | 64.4% | 17.4% | 42.4% |
| 컴퓨터 사용 안전성 위반율 | 4.3% | 17.4% | 2.4% | 13.7% |
WSJ는 9월 28일, 10월 ChatGPT와 Codex에 출시할 예정이던 GPT-6.1 Astra 계획이 내부 안전성 평가 문제로 취소됐다고 보도했습니다. 관련 보도 제목은 OpenAI Scraps Release of New AI Model Over Safety Concerns입니다.
출처: X @OpenAIDevs
Opus 5.5·Sonnet 5.5와 비교하면
절대 성능의 맨 앞자리는 아직 Claude 쪽에 있습니다. Anthropic이 9월 28일 발표한 Sonnet 5.5는 Terminal-Bench 4.0에서 70.6%, Opus 5.5는 66.4%였습니다. GDPval-AA는 Opus 5.5가 1,846, Sonnet 5.5가 1,844입니다.
Artificial Analysis 종합 지수는 Opus 5.5 58, Sonnet 5.5 56, Astra 53, GPT-6.1 Sol max 52, GPT-6 Sol 48입니다. FrontierCode에서는 Opus 5.5가 54.4%, Sonnet 5.5가 Xhigh 설정에서 52.1%, GPT-6 Sol이 49.3%였습니다. GPT-6.1 Sol은 Astra 바로 아래, Sonnet 5.5 아래에 자리합니다.
출처: X @ArtificialAnlys
정가가 같아도 실제 비용은 다르다
GPT-6.1 Sol과 Sonnet 5.5는 입력 $2·출력 $10, Opus 5.5는 입력 $4·출력 $20입니다. 캐시 읽기는 Sonnet·Opus가 $0.20, GPT-6.1 Sol은 $0.10입니다. 코딩 에이전트처럼 반복 입력을 캐시하는 작업은 이 차이가 누적됩니다.
Artificial Analysis 측정에서 Sonnet 5.5 최대 설정은 과제당 출력 토큰이 약 19만 3천 개였습니다. Opus 5.5 최대 설정보다 약 60%, Astra 최대 설정보다 약 7배 많은 양입니다.
출처: X @ArtificialAnlys
OpenAI의 노엄 브라운은 OpenAI가 모델 평가를 이렇게 비용과 함께 보여 주는 것이 반갑다며, 지능은 비용의 함수로 재야 한다고 말했습니다.
출처: X @polynoamial
ChatGPT Pro 요금제도 API 비용 기준으로
9월 29일 오후 3시 41분 KST, Tibo는 Pro $200 신규 가입을 재개하면서 사용량 산정 기준을 바꾼다고 밝혔습니다. API 비용으로 환산한 사용량은 기존 Pro $200의 절반 수준이지만, 5시간 한도를 다시 도입하지 않고 모델 효율 개선을 API 가격 인하로 반영하겠다는 설명입니다. 정가를 부풀린 뒤 할인하는 방식도 쓰지 않겠다고 했습니다.
출처: X @thsottiaux
DevDay 당일인 9월 30일 0시 10분(KST) 공개한 상대 사용량은 Plus 1배, Pro $100 5배, Pro $200 10배입니다. 기존 Pro $200 가입자는 한동안 20배를 유지하며 추가 크레딧도 받습니다. 별도로 월 $500 Pro 등급에는 최대 사용량과 GPT-6 Astra·GPT-6.1 Sol Ultrafast가 포함됩니다. Ultrafast는 Astra보다 최대 8배 빠르며 API에서도 이용할 수 있습니다.
출처: X @thsottiaux
DeepSWE 비용만 놓고 보면 Astra 최고점 설정($4.43) 대신 GPT-6.1 Sol high($0.65)를 쓸 때 같은 예산으로 약 6.8배 많은 과제를 처리할 수 있습니다. 사용 한도가 절반으로 조정돼도 단순 계산상 처리량은 3배 이상입니다.
최고점은 Astra·Opus, 반복 작업은 6.1 Sol
가장 어려운 과학 평가와 자동화의 최고점은 Astra와 Opus 5.5가 지킵니다. GPT-6.1 Sol이 바꾼 지점은 그 아래의 실용 구간입니다. Astra에 가까운 코딩·컴퓨터 사용 성능을 훨씬 낮은 작업당 비용으로 반복 실행할 수 있습니다. 에이전트를 몇 번 돌릴 수 있는지를 결정하는 기준도 모델 이름에서 작업당 비용으로 옮겨갑니다.